Односвязный список
Структура и инварианты
Односвязный список — цепочка узлов, каждый из которых хранит данные и указатель на
следующий узел. Для ЛР 3 данные — это Student:
typedef struct
{
    int id;
    int course;
    double score;
} Student;

typedef struct Node
{
    Student data;       /* полезные данные */
    struct Node *next;  /* адрес следующего узла, NULL — конец списка */
} Node;
Список задаётся указателем на первый узел:
Node *head = NULL; /* пустой список */
Список всегда подчиняется двум инвариантам — свойствам, которые верны в любой момент между операциями:
head == NULLозначает пустой список; у непустого спискаheadуказывает на первый узел.nextпоследнего узла равенNULL; больше никакой узел наNULLне ссылается.
Инварианты полезны как проверка: если после какой-то операции next «последнего» узла
окажется не NULL, или голова будет потеряна, — значит, где-то ошибка. Ниже все операции
мы строим так, чтобы инварианты сохранялись.
Добавление в начало: push_front
Самый быстрый способ вставить узел — поставить его первым. Работает за O(1) и не требует обхода списка.
Node *push_front(Node *head, Student s)
{
    Node *node = make_node(s);
    if (node == NULL)
    {
        return head;      /* не выделилось — список не изменился */
    }

    node->next = head;    /* прицепляем старый список к новому узлу */
    return node;          /* новый узел стал головой */
}
Здесь критичен порядок двух действий. Сначала node->next = head — новый узел
прицепляется к текущему списку. Только потом голова переставляется на новый узел. Если
сделать наоборот (сначала переставить head, а потом прицепить), старый список будет
потерян: head уже указывает на новый узел, а ссылка на прежний первый узел исчезла.
Получится утечка — до узлов больше не добраться.
Добавление в конец: push_back
Чтобы добавить в конец, нужно дойти до последнего узла. Есть два варианта: с указателем на хвост и без него.
Без tail — каждый раз идём от головы до конца:
Node *push_back(Node *head, Student s)
{
    Node *node = make_node(s);
    if (node == NULL)
    {
        return head;
    }

    if (head == NULL)
    {
        return node;      /* список был пуст */
    }

    Node *p = head;
    while (p->next != NULL)
    {
        p = p->next;
    }
    p->next = node;
    return head;
}
Это O(N) на одну вставку: чтобы добавить N элементов по одному, понадобится O(N²). Для
учебных объёмов это терпимо, но можно быстрее.
С tail — держим второй указатель на последний узел. Тогда вставка в конец — O(1), как и в начало:
typedef struct
{
    Node *head;
    Node *tail;
} List;

void push_back(List *list, Student s)
{
    Node *node = make_node(s);
    if (node == NULL)
    {
        return;
    }

    node->next = NULL;

    if (list->tail == NULL)
    {
        list->head = list->tail = node;   /* список был пуст */
    }
    else
    {
        list->tail->next = node;
        list->tail = node;
    }
}
Плата за скорость — следить за tail: при удалении последнего узла его нужно отодвигать
назад, а для односвязного списка это снова обход O(N). Поэтому tail выгоден только там,
где конец нужен часто, а удаления с конца редки. В ЛР 3 простые варианты спокойно обходятся
одним head; tail удобен для задач со слиянием или разделением, где приходится быстро
прицеплять к концу.
Вставка после узла: insert_after
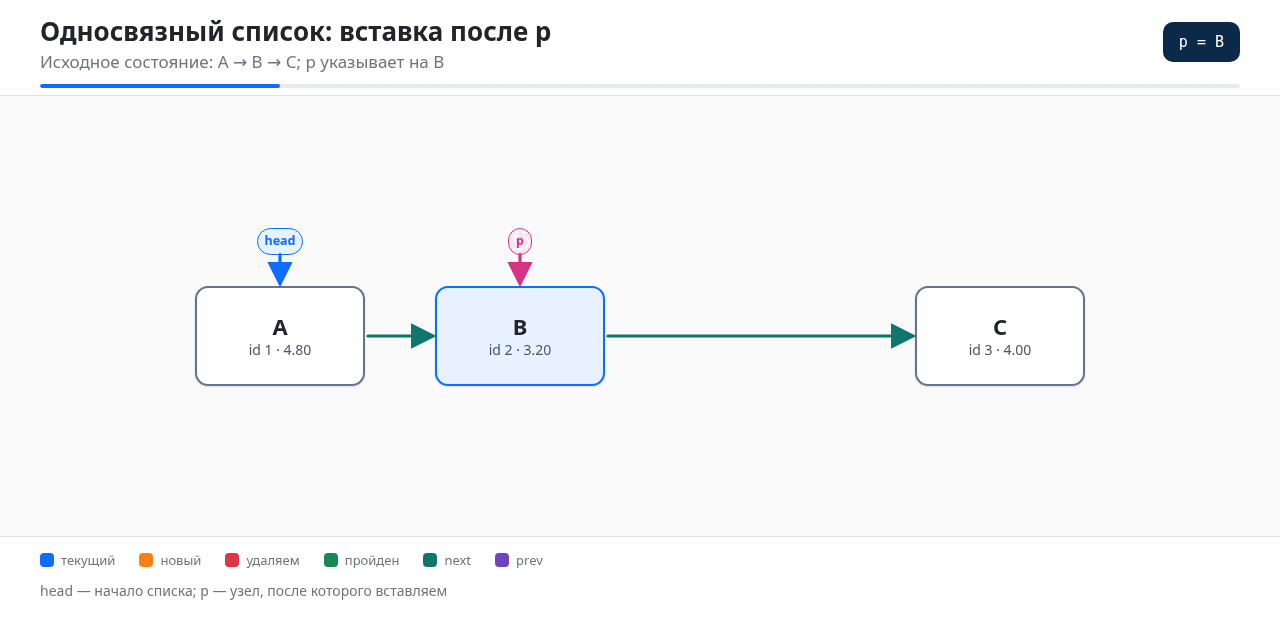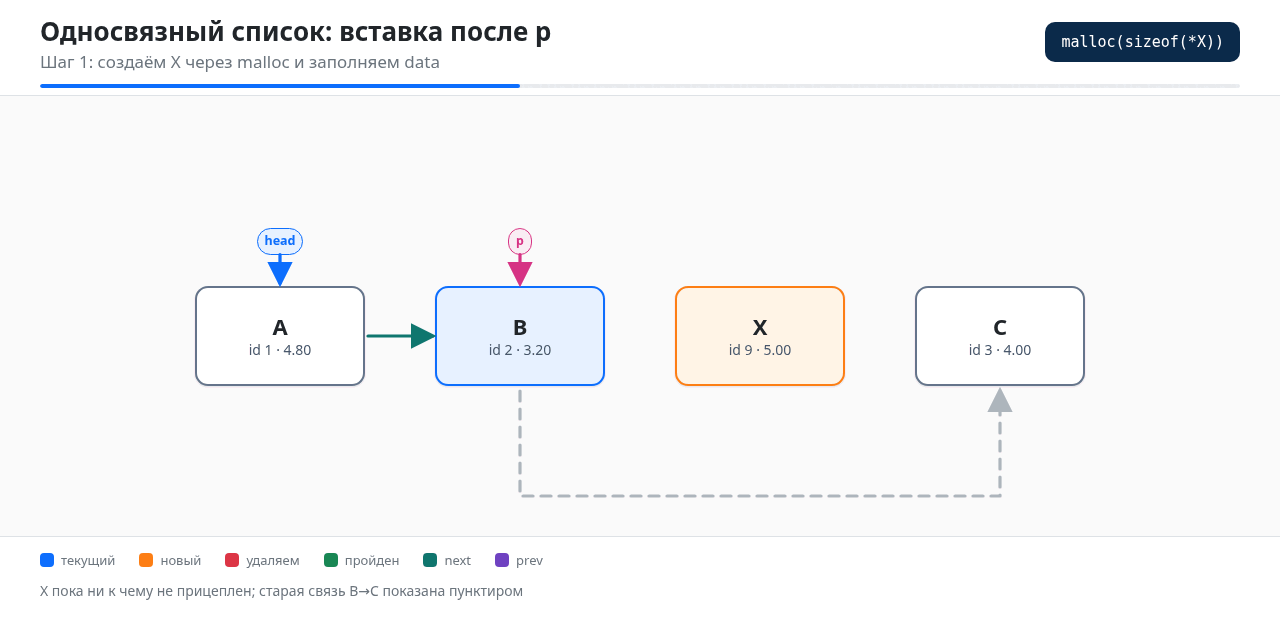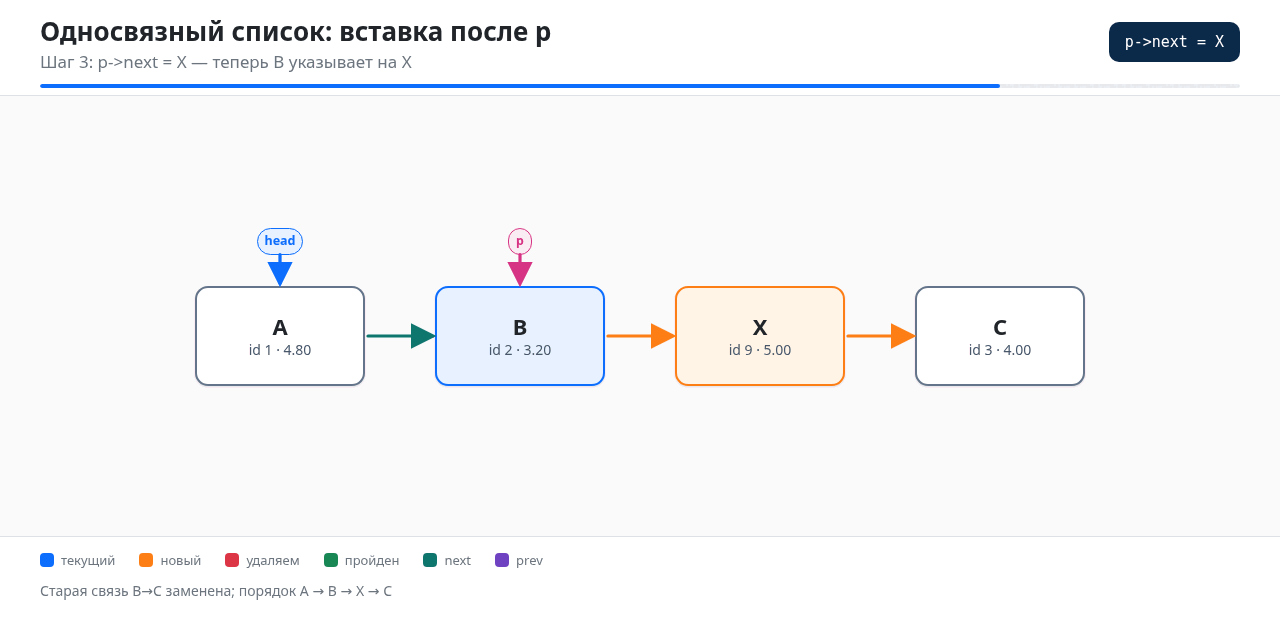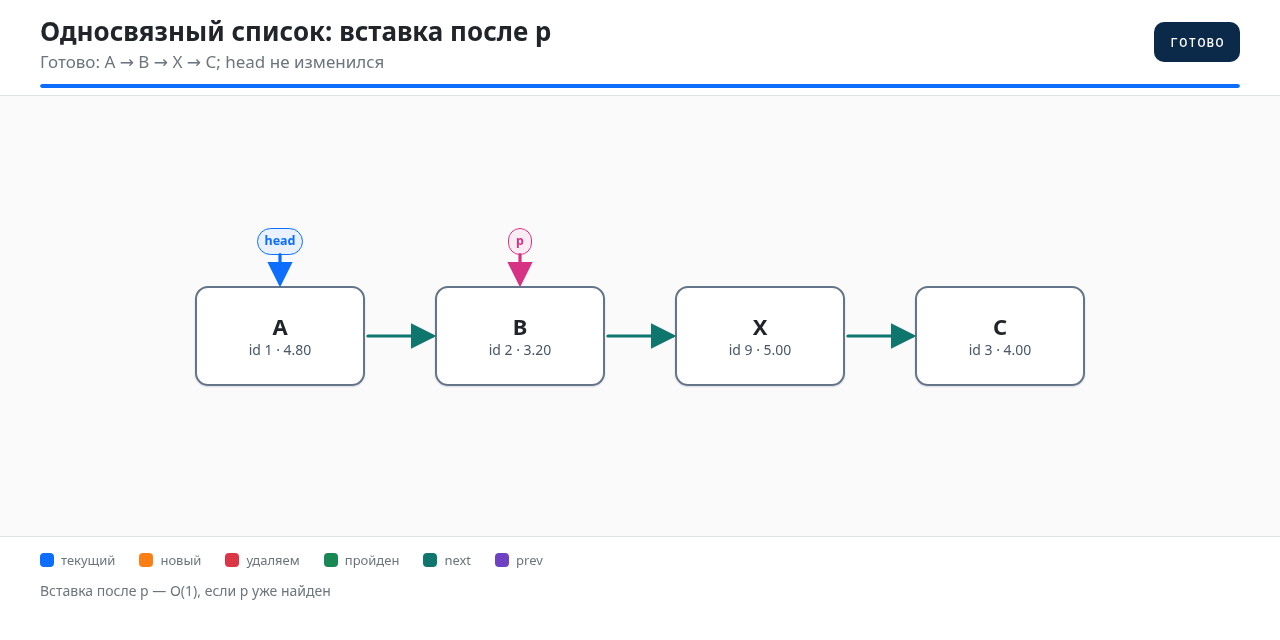
Вставка в середину — главное преимущество списка: не нужно сдвигать элементы. Чтобы вставить
node после узла p, выполняют два шага в правильном порядке.
Node *insert_after(Node *p, Student s)
{
    if (p == NULL)
    {
        return NULL;        /* некуда вставлять */
    }

    Node *node = make_node(s);
    if (node == NULL)
    {
        return NULL;
    }

    node->next = p->next;   /* 1. новый узел берёт следующий за p */
    p->next = node;         /* 2. p теперь указывает на новый узел */
    return node;
}
Порядок принципиален. Сначала новый узел должен «унаследовать» p->next, и только потом
p->next переписывается на новый узел. Если сначала сделать p->next = node, адрес
прежнего следующего узла будет потерян — всё, что было после p, окажется недостижимо
(утечка). Формула запоминается как «сначала подхвати хвост, потом вставься».
Удаление первого узла по значению: remove_first
При удалении нужен предыдущий узел: именно его next перецепляют через удаляемый.
Node *remove_first(Node *head, int id)
{
    Node *prev = NULL;
    Node *cur = head;

    while (cur != NULL && cur->data.id != id)
    {
        prev = cur;
        cur = cur->next;
    }

    if (cur == NULL)
    {
        return head;          /* такого id нет */
    }

    if (prev == NULL)
    {
        head = cur->next;     /* удаляем голову */
    }
    else
    {
        prev->next = cur->next;   /* «перепрыгиваем» удаляемый узел */
    }

    free(cur);
    return head;
}
Разберём удаление головы отдельно. Если удаляется первый узел, то prev == NULL, и
перецеплять нечего — меняется сама голова: head = cur->next. Именно поэтому функция
возвращает новый head (или можно было передать Node **). Если этого не сделать, head
так и будет указывать на уже освобождённый узел — висячий указатель.
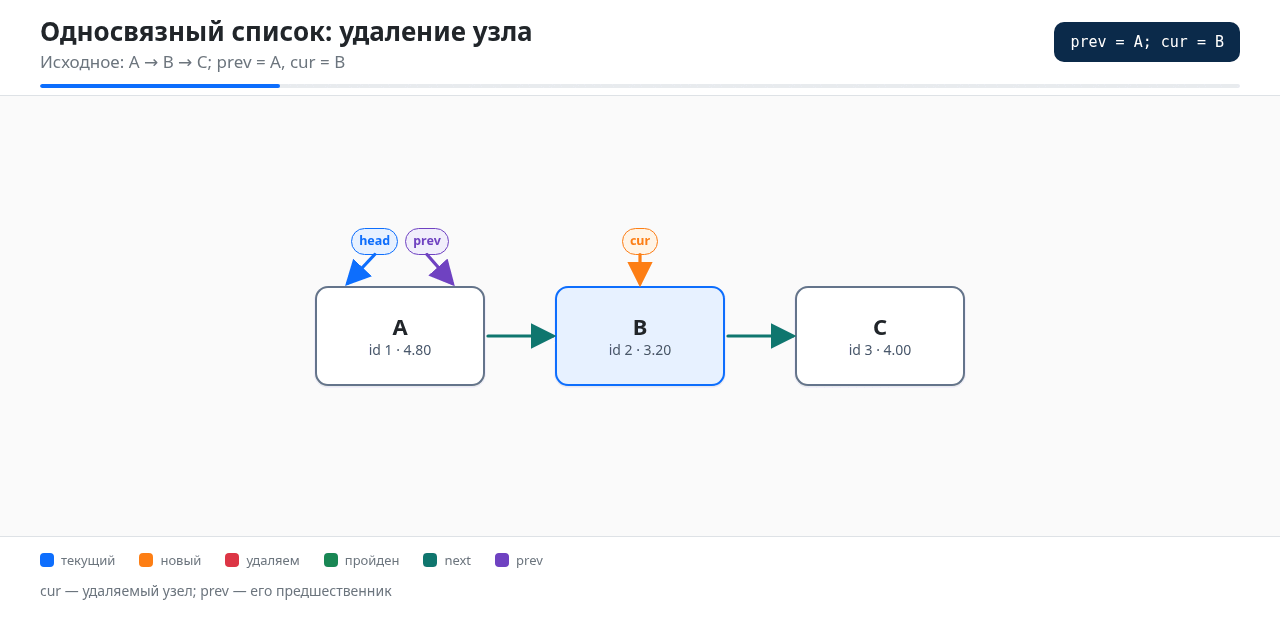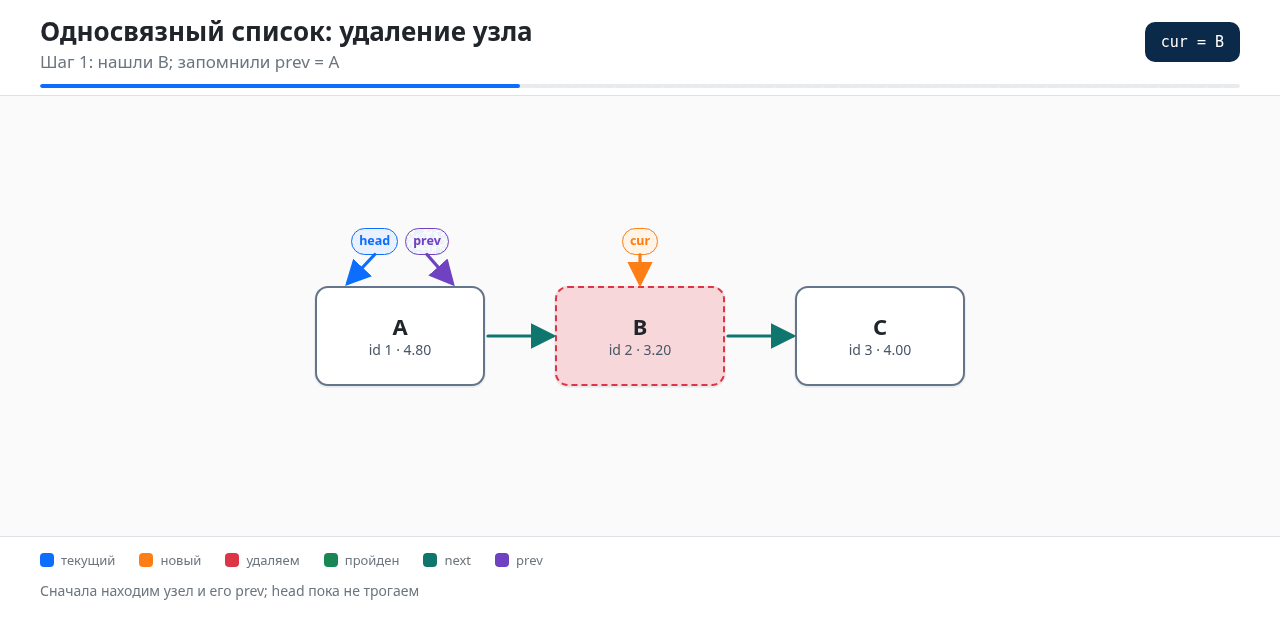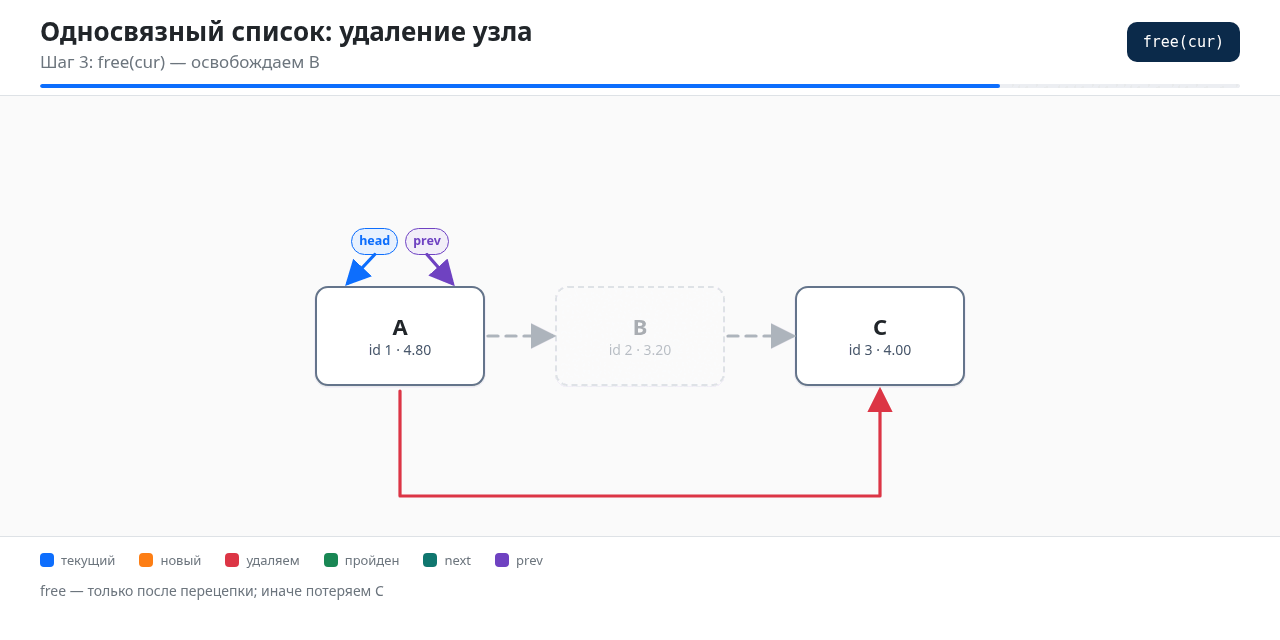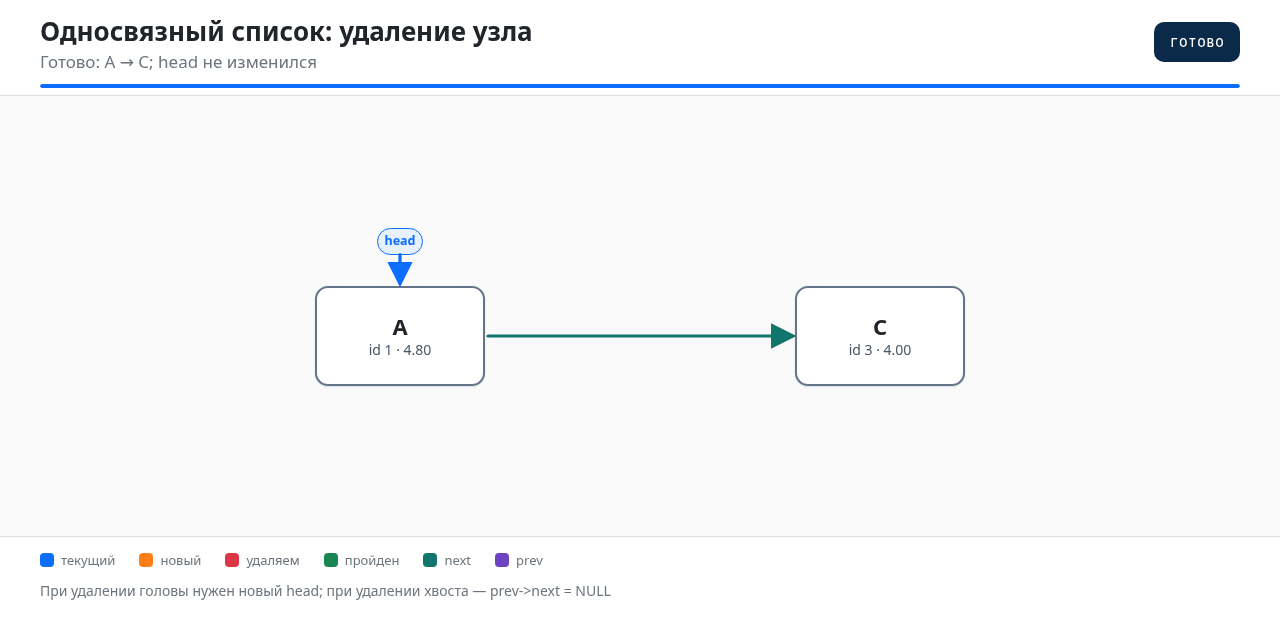
free(cur) вызывают только после перецепки. Пока узел не освобождён, его next можно
читать; как только free сделан — читать нельзя. Порядок «сначала перецепляем, потом
освобождаем» — общее правило для всех операций удаления.
Удаление всех узлов по условию: remove_all
Для вариантов вида «удалить все записи ниже порога» нужна версия, удаляющая несколько узлов подряд:
Node *remove_all(Node *head, double threshold)
{
    Node *cur = head;
    Node *prev = NULL;

    while (cur != NULL)
    {
        if (cur->data.score < threshold)
        {
            Node *next = cur->next;   /* запоминаем до free */
            if (prev == NULL)
            {
                head = next;
            }
            else
            {
                prev->next = next;
            }
            free(cur);
            cur = next;               /* prev НЕ двигаем */
        }
        else
        {
            prev = cur;
            cur = cur->next;
        }
    }

    return head;
}
Ключевой момент — когда узел удалён, prev не двигают: следующий узел может тоже
подлежать удалению, и тогда его нужно перецепить через тот же prev. Перед free(cur)
сохраняют next = cur->next, чтобы было куда перейти после освобождения. Такой приём
понадобится в вариантах 4, 6, 7 и 20 основной группы.
Разворот списка: reverse
Разворот меняет порядок узлов на противоположный, не создавая новый список, а переставляя
ссылки next. Используются три указателя — prev, cur, next:
Node *reverse(Node *head)
{
    Node *prev = NULL;
    Node *cur = head;

    while (cur != NULL)
    {
        Node *next = cur->next;   /* 1. запоминаем следующий */
        cur->next = prev;         /* 2. разворачиваем ссылку */
        prev = cur;               /* 3. сдвигаем prev */
        cur = next;               /* 4. сдвигаем cur */
    }

    return prev;                  /* новая голова */
}
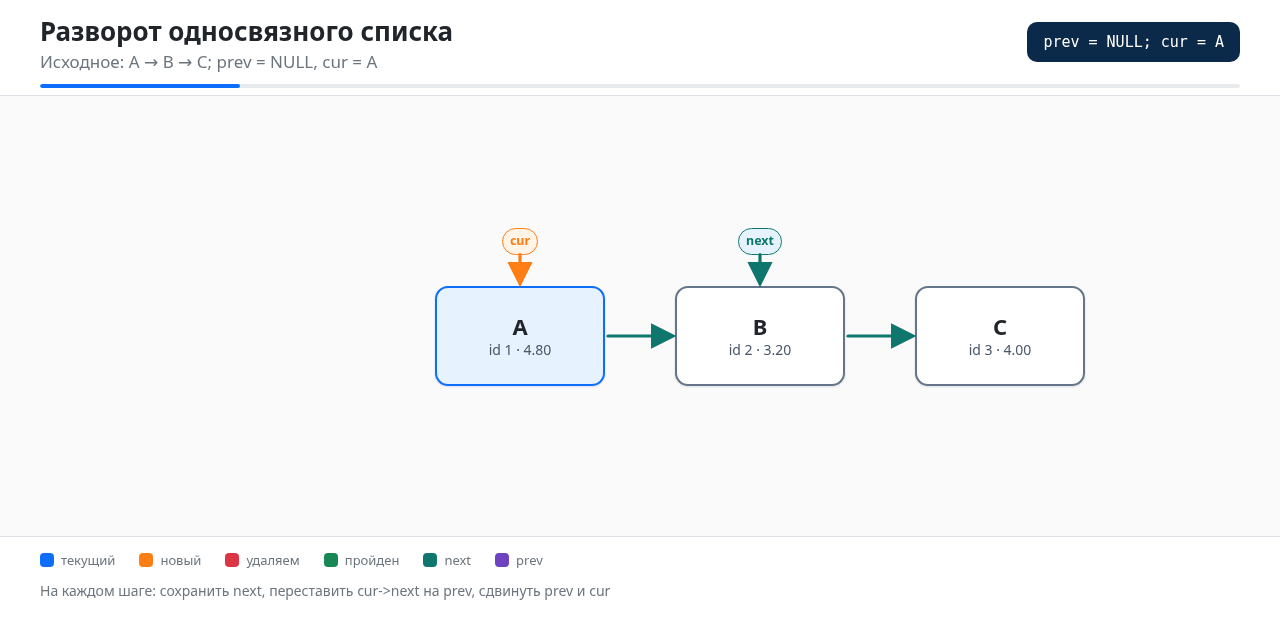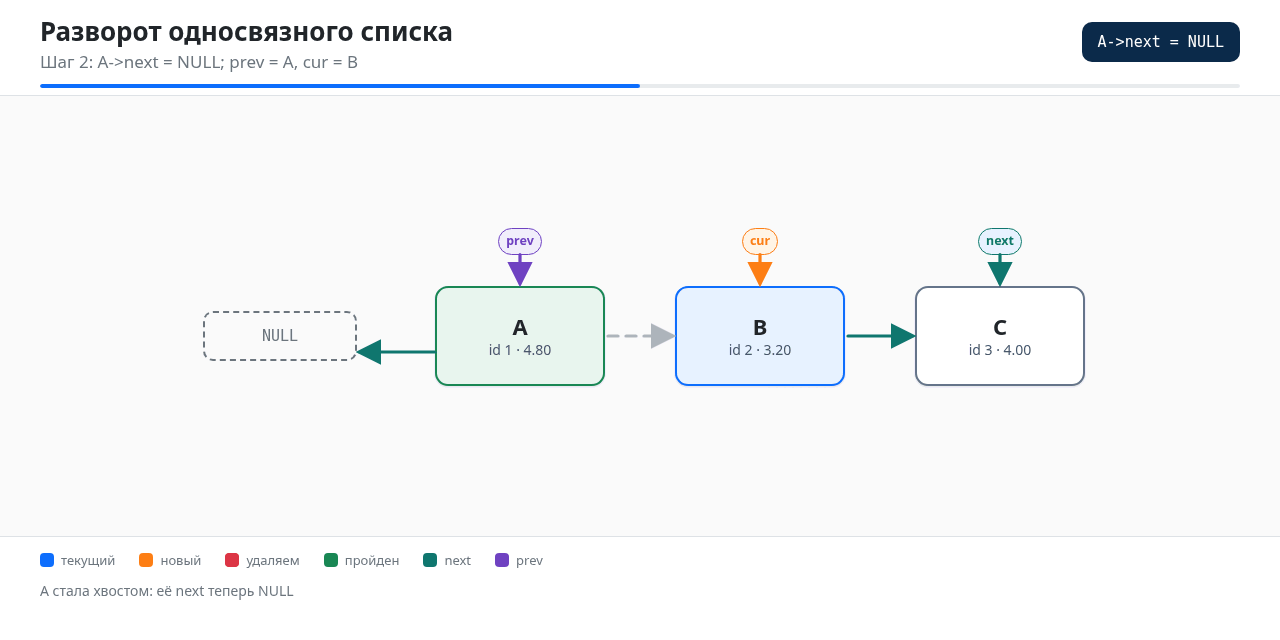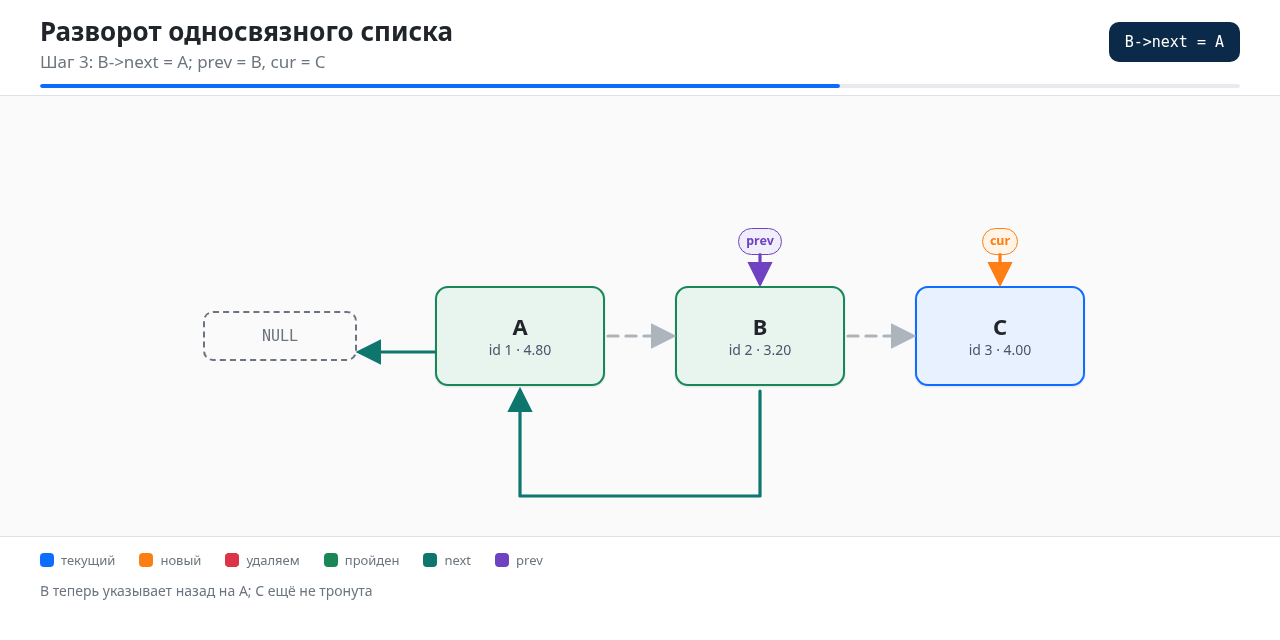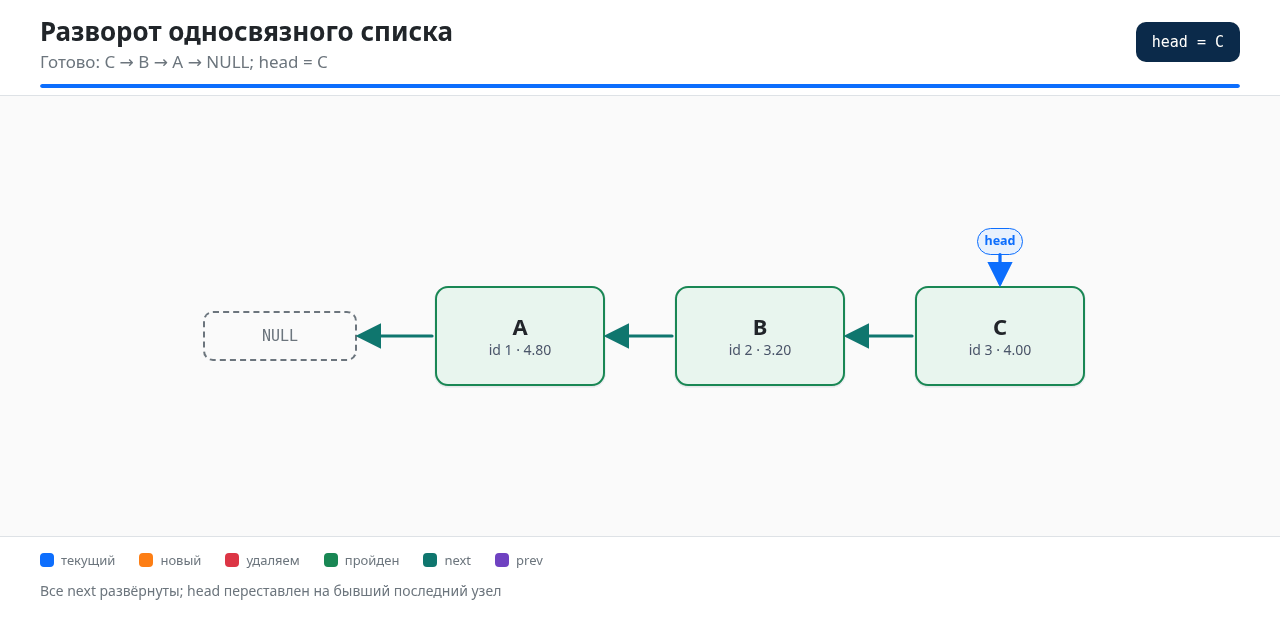
Пошагово на каждом витке:
next = cur->next— запоминаем, куда идти дальше, до того как перепишемcur->next.cur->next = prev— разворачиваем текущий узел: теперь он указывает назад.prev = cur— бывший текущий становится новым «предыдущим».cur = next— переходим к сохранённому следующему.
После цикла prev указывает на бывший последний узел — это новая голова.
Классическая ошибка — потерять next. Если пропустить шаг 1 и сразу переписать
cur->next = prev, дальше по списку двигаться будет некуда: адрес следующего узла стёрт.
Без сохранённого next развернётся только один узел, а остальной список окажется потерян.
Поиск и освобождение
Поиск узла по значению возвращает указатель на узел или NULL:
Node *find(Node *head, int id)
{
    for (Node *p = head; p != NULL; p = p->next)
    {
        if (p->data.id == id)
        {
            return p;
        }
    }
    return NULL;
}
Вызывающий код обязан проверить результат: find возвращает NULL, если узла нет, и
разыменовывать этот NULL нельзя.
Освобождение всего списка:
void free_list(Node *head)
{
    while (head != NULL)
    {
        Node *next = head->next;   /* СНАЧАЛА сохраняем следующий */
        free(head);
        head = next;
    }
}
Здесь тоже действует правило «сохрани next до free». После освобождения вызывающий код
обнуляет свою голову: head = NULL;.
Таблица сложности
N — число узлов в списке.
| Операция | Без tail | С tail |
|---|---|---|
push_front | O(1) | O(1) |
push_back | O(N) | O(1) |
insert_after | O(1) | O(1) |
remove_first (по значению) | O(N) | O(N) |
remove_all (по условию) | O(N) | O(N) |
reverse | O(N) | O(N) |
find | O(N) | O(N) |
free_list | O(N) | O(N) |
Доступ к i-му узлу всегда O(N): к элементу списка нельзя «прыгнуть» по индексу, до него
нужно дойти по цепочке. Это плата за дешёвые вставку и удаление в середину.
Полный пример: стабильное разделение по порогу
Многие варианты основной группы (1, 2, 3, 5, 8, 14) требуют стабильной перестановки: разбить список на две группы по условию, сохранив порядок внутри каждой группы. Классический способ — пройти по списку один раз и растащить узлы в два временных списка (с хвостами), а потом сцепить их.
Node *partition_by_score(Node *head, double threshold)
{
    Node *high_head = NULL, *high_tail = NULL;   /* score >= порога */
    Node *low_head  = NULL, *low_tail  = NULL;   /* score < порога */

    Node *cur = head;
    while (cur != NULL)
    {
        Node *next = cur->next;   /* сохраняем, т.к. дальше отцепляем узел */
        cur->next = NULL;         /* отцепляем текущий узел от списка */

        if (cur->data.score >= threshold)
        {
            if (high_tail == NULL)
            {
                high_head = high_tail = cur;
            }
            else
            {
                high_tail->next = cur;
                high_tail = cur;
            }
        }
        else
        {
            if (low_tail == NULL)
            {
                low_head = low_tail = cur;
            }
            else
            {
                low_tail->next = cur;
                low_tail = cur;
            }
        }

        cur = next;
    }

    /* Сцепляем: сначала группа с score >= порога, затем остальные */
    if (high_head == NULL)
    {
        return low_head;
    }
    high_tail->next = low_head;
    return high_head;
}
Почему это стабильно: узлы растаскиваются по одному, в порядке исходного списка, и в
каждом временном списке они прицепляются в хвост. Поэтому относительный порядок внутри
каждой группы сохраняется — ровно то, что требуют варианты 1–3, 5, 8 и 14. Здесь же хорошо
виден смысл tail: он позволяет добавлять в конец временного списка за O(1).
Другой распространённый случай — удаление по условию (варианты 4, 6, 7, 20). Для него
используется тот же приём, что в remove_all: сохранить next, перецепить prev->next,
освободить узел и не двигать prev, если следующий узел тоже может быть удалён. Меняется
только условие (score < T, course == K, score == min, номер позиции и т. п.).
Связь с ЛР 3
Основная группа (варианты 1–20) строится ровно на описанных здесь операциях. Вот какая операция лежит в основе каждого семейства вариантов:
| Операция | Где нужна |
|---|---|
| Стабильная перестановка (разделение по условию) | 1, 2, 3, 5, 8, 14 |
| Поиск максимума и перенос узла в начало | 16 |
Удаление по условию (remove_all) | 4, 6, 7, 20 |
Разворот списка (reverse) | 9, 12, 13 |
| Обмен половинами / сдвиг | 10, 11 |
| Чередование пар | 15 |
| Слияние двух списков | 17, 18, 19 |
Все варианты читают input.txt, строят список через malloc в цикле, преобразуют его и
пишут в output.txt. Важное правило ЛР 3: хранить все данные в массиве или имитировать
список массивом запрещено — каждый узел должен быть отдельным malloc, а преобразование
работает именно со ссылками next, а не с перестановкой значений в массиве. Используйте
одно из семейств функций выше как основу функции преобразования.
Проверь себя
1. Почему в insert_after нельзя сначала написать p->next = node, а потом
node->next = p->next?
Второе действие прочитало бы уже новый p->next, то есть адрес самого node, — получился
бы узел, ссылающийся сам на себя, а прежний хвост (всё, что было после p) оказался бы
потерян. Правильный порядок: сначала node->next = p->next (подхватить хвост), потом
p->next = node.
2. Почему при развороте списка нужен третий указатель next?
Потому что перед переписыванием cur->next = prev адрес настоящего следующего узла ещё
хранится в cur->next. Если его не сохранить заранее в next, после перезаписи двигаться
дальше по списку будет некуда — список потеряется.
Частые ошибки
| Ошибка | Что не так |
|---|---|
| неправильный порядок при вставке | потерян хвост списка, утечка |
free(cur) до перецепки | обращение к освобождённой памяти |
не обновили head при удалении головы | висячий указатель на освобождённый узел |
потеряли next при развороте | список обрывается после первого узла |
remove_all двигает prev после удаления | пропуск соседних удаляемых узлов |
| хранили все данные в массиве | нарушение требования ЛР 3 |
| не освободили список в конце | утечка памяти |
Что запомнить
- Односвязный список задаётся головой;
nextпоследнего узла равенNULL. - При вставке сначала подхватывают хвост (
node->next = p->next), потом вставляются. - При удалении сначала перецепляют
nextпредыдущего узла, потомfree. - Удаление головы требует вернуть новый
headили передатьNode **. - Разворот — три указателя
prev/cur/next;nextсохраняют до перезаписи ссылки. tailделаетpush_backза O(1), но его надо поддерживать при удалении с конца.- Доступ по индексу — O(N), вставка/удаление в середину — O(1) после нахождения места.