Двусвязный список
Структура и инварианты
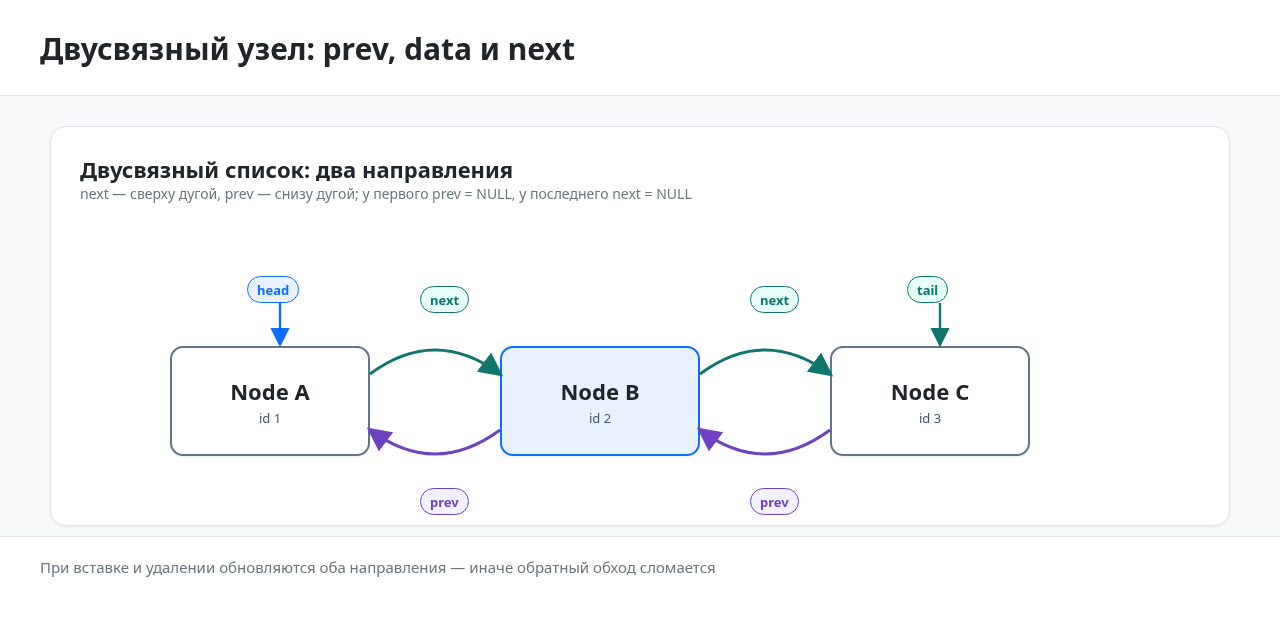
В односвязном списке можно двигаться только вперёд: чтобы удалить узел, нужен предыдущий, а чтобы вернуться назад — вообще нет способа. Двусвязный список решает это, храня в каждом узле два указателя — на предыдущий и на следующий:
typedef struct
{
    int id;
    int course;
    double score;
} Student;

typedef struct DNode
{
    Student data;
    struct DNode *prev;   /* адрес предыдущего узла, NULL у головы */
    struct DNode *next;   /* адрес следующего узла, NULL у хвоста */
} DNode;
Список удобно задавать двумя указателями — на первый и на последний узел:
typedef struct
{
    DNode *head;
    DNode *tail;
} DList;
Пустой список: head == NULL и tail == NULL. Для непустого списка всегда выполняются
инварианты:
head->prev == NULL— у первого узла нет предыдущего;tail->next == NULL— у последнего нет следующего;p->next->prev == pдля любого не последнего узлаp— сосед слева и справа «согласованы»;p->prev->next == pдля любого не первого узлаp— то же, с другой стороны.
Свойства 3 и 4 читаются как «если пойти вперёд, а потом назад, вернёшься туда же». Именно они ломаются чаще всего, когда забывают обновить одну из четырёх ссылок. Держите их в голове как проверку после каждой операции.
Цена второго указателя. Каждый узел занимает больше памяти — лишние 8 байт на prev.
Зато удаление узла становится O(1) (не нужен поиск предыдущего), появляется обход назад,
и вставка перед узлом столь же проста, как после.
Вставка после и перед узлом
В двусвязном списке вставка затрагивает четыре ссылки: два указателя нового узла и два указателя соседей (или голову/хвост, если соседа нет).
Вставка нового узла node после узла p:
DNode *insert_after(DList *list, DNode *p, Student s)
{
    if (p == NULL)
    {
        return NULL;            /* некуда вставлять */
    }

    DNode *node = make_node(s);
    if (node == NULL)
    {
        return NULL;
    }

    node->next = p->next;       /* 1. новый узел берёт следующий за p */
    node->prev = p;             /* 2. а предыдущим для него становится p */

    if (p->next != NULL)        /* 3. если за p был узел — он теперь ссылается назад */
    {
        p->next->prev = node;
    }
    else                        /*    иначе новый узел — новый хвост */
    {
        list->tail = node;
    }

    p->next = node;             /* 4. p указывает на новый узел */
    return node;
}
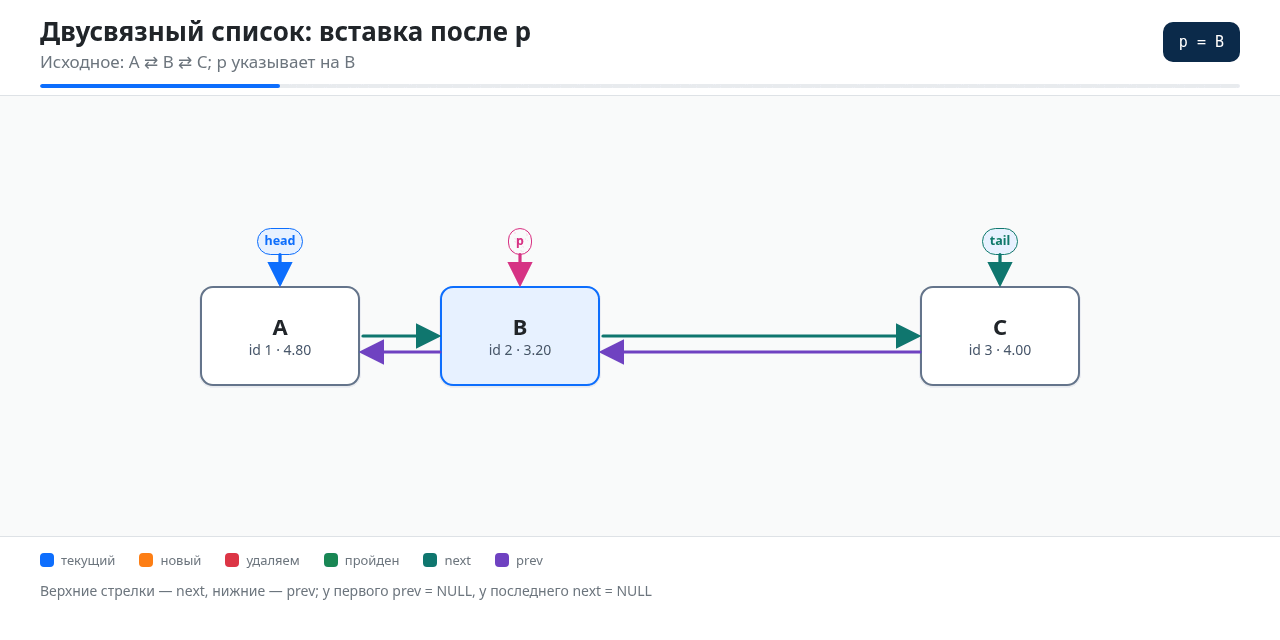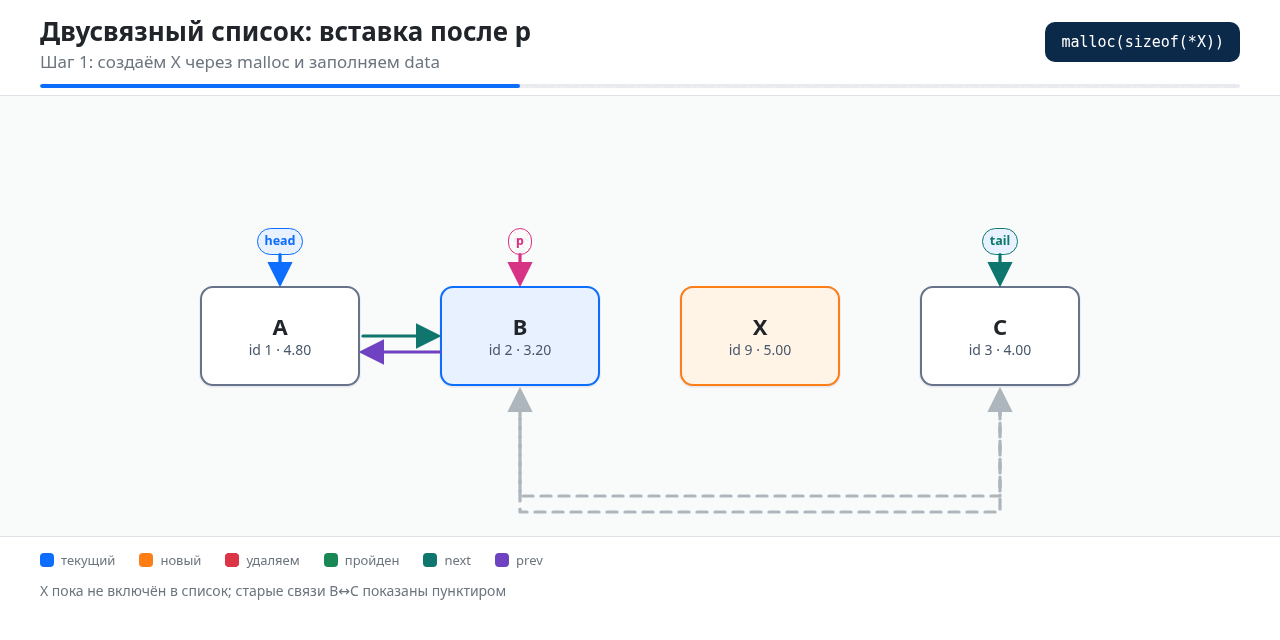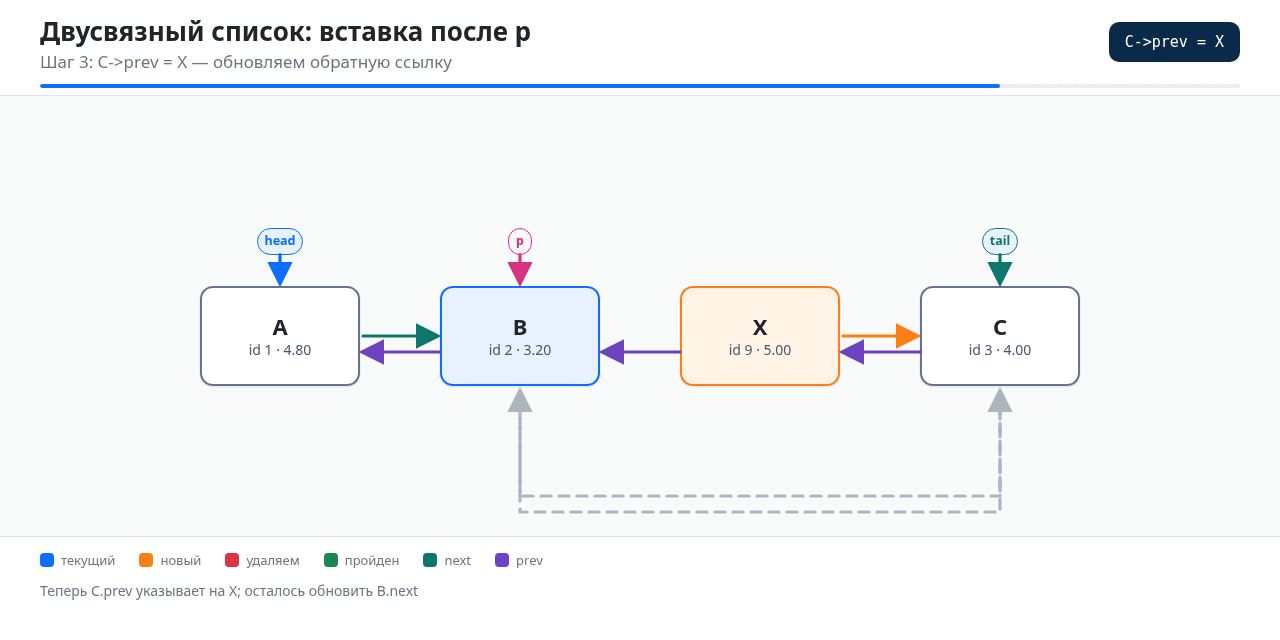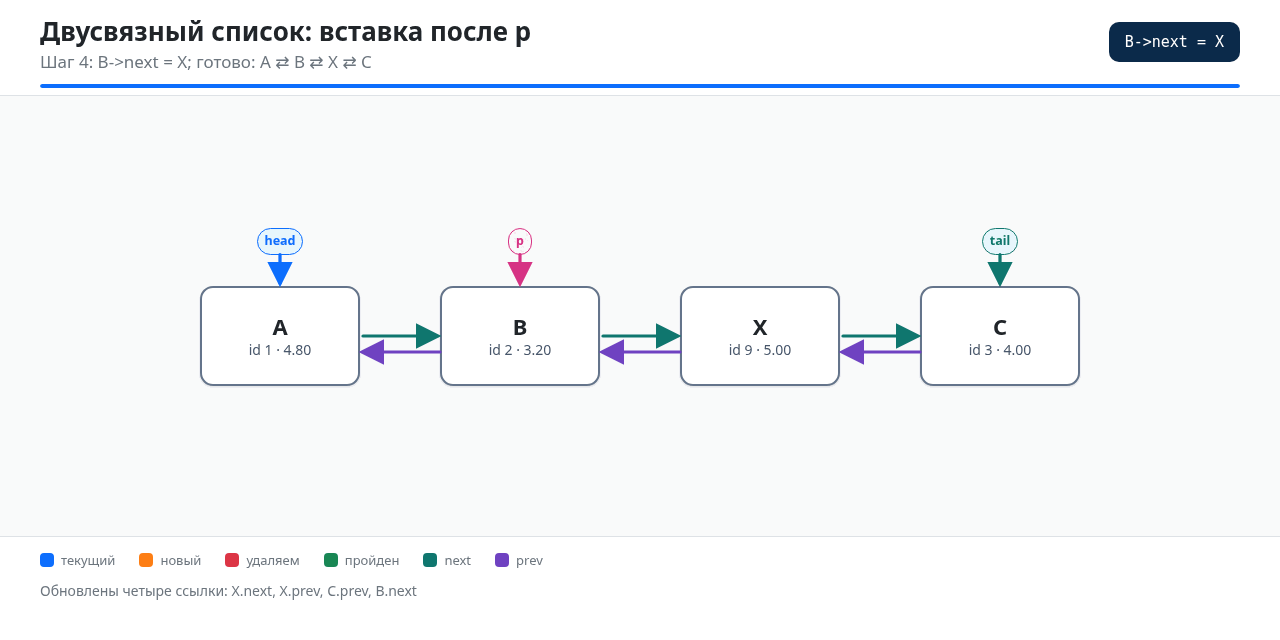
Порядок шагов важен. Сначала настраивают новый узел (шаги 1–2), потому что он пока
нигде не участвует и «ломать» нечего. Затем поправляют соседа справа (шаг 3) — его prev
должен теперь смотреть на новый узел. И только в самом конце переписывают p->next (шаг 4).
Если переписать p->next раньше, чем настроить p->next->prev, то при чтении p->next->prev
мы обратимся уже к новому узлу и перепутаем ссылки, либо потеряем адрес старого правого
соседа.
Вставка перед узлом симметрична: меняются роли next и prev. Её удобно свести к
вставке после p->prev, но с отдельной обработкой случая, когда p — голова (тогда
обновляется list->head).
push_front и push_back
Добавление в начало и в конец — частные случаи вставки, но их проще написать напрямую.
void push_front(DList *list, Student s)
{
    DNode *node = make_node(s);
    if (node == NULL)
    {
        return;
    }

    node->next = list->head;
    node->prev = NULL;

    if (list->head != NULL)
    {
        list->head->prev = node;   /* старый первый ссылается назад */
    }
    else
    {
        list->tail = node;         /* список был пуст */
    }

    list->head = node;
}
push_back строится симметрично: новый узел прицепляется к tail. Разберите его
самостоятельно по образцу — это хорошая проверка того, что вы поняли, какие именно четыре
ссылки обновляются и как защищаться от NULL.
Удаление узла
Удаление узла p — операция O(1): не нужно искать предыдущий, он уже хранится в p->prev.
void remove_node(DList *list, DNode *p)
{
    if (p == NULL)
    {
        return;
    }

    /* Перецепляем соседей через p, не трогая сам p */
    if (p->prev != NULL)
    {
        p->prev->next = p->next;   /* левый сосед пропускает p вперёд */
    }
    else
    {
        list->head = p->next;      /* удаляем голову */
    }

    if (p->next != NULL)
    {
        p->next->prev = p->prev;   /* правый сосед пропускает p назад */
    }
    else
    {
        list->tail = p->prev;      /* удаляем хвост */
    }

    free(p);                       /* только после перецепки */
}
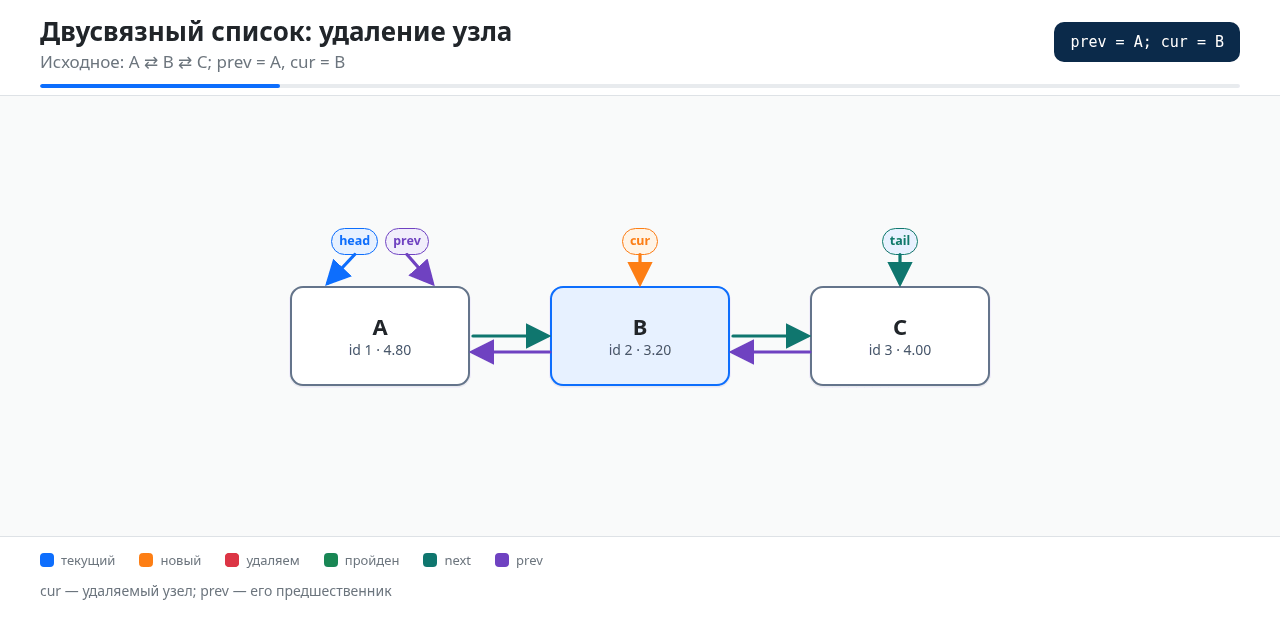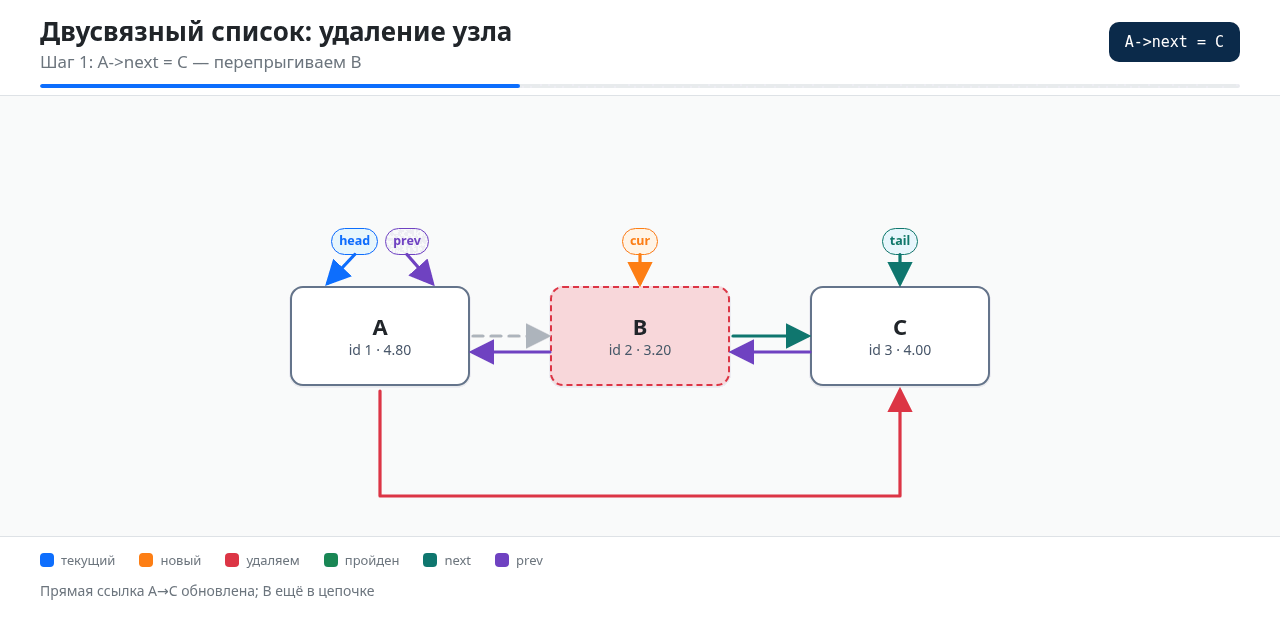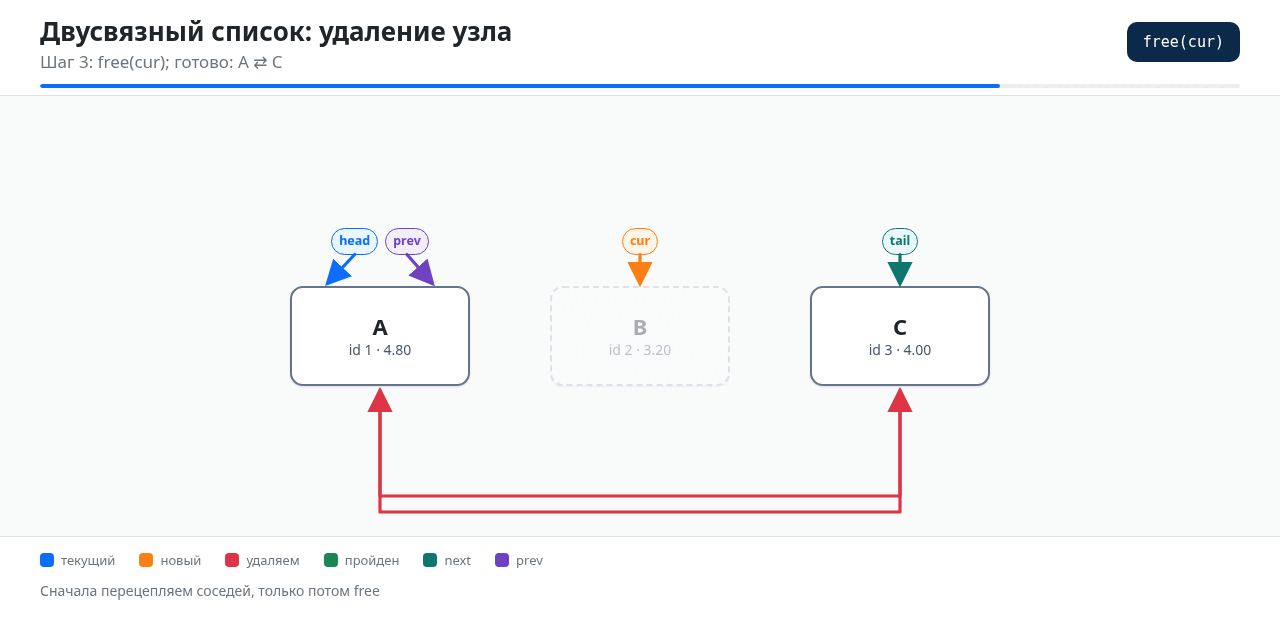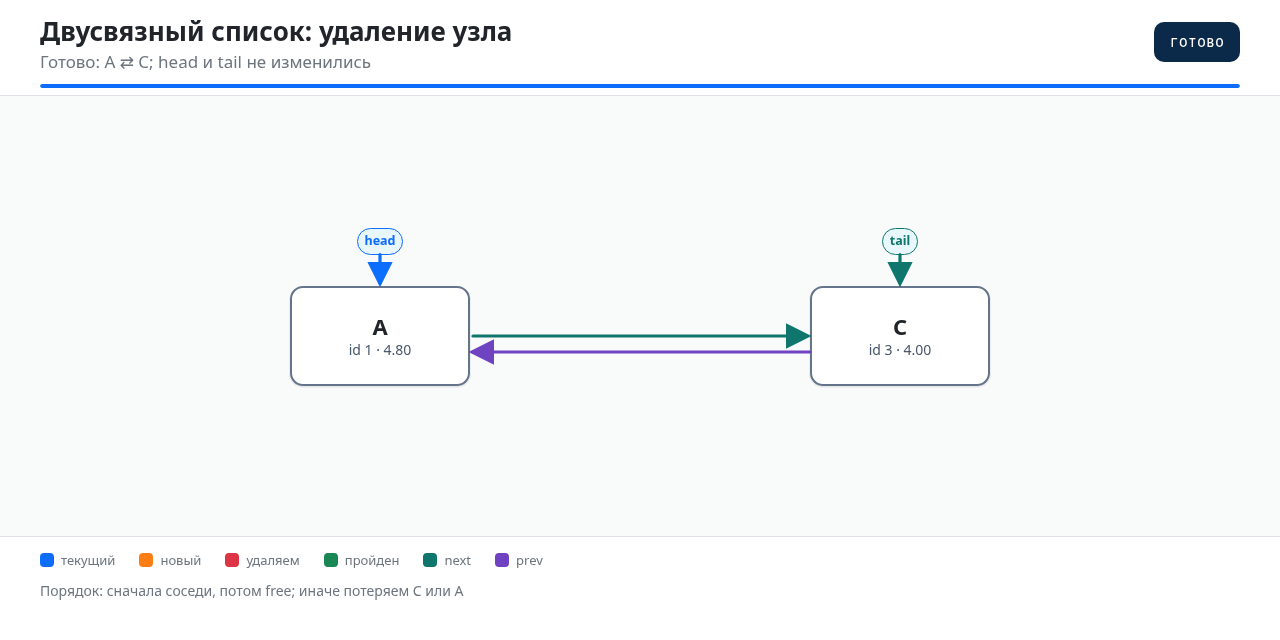
Здесь обновляются две ссылки (а не четыре, как при вставке): prev->next и next->prev.
Особые случаи — голова (p->prev == NULL), хвост (p->next == NULL) и
единственный узел (обе проверки срабатывают сразу, и оба указателя head/tail
обнуляются). Каждая ветка проверяет соседа на NULL, поэтому разыменования пустого
указателя не происходит.
Порядок «сначала перецепляем соседей, потом free(p)» критичен: пока узел жив, его prev
и next можно читать. После free любое обращение к p — неопределённое поведение.
Обход в обе стороны
/* вперёд */
for (DNode *p = list->head; p != NULL; p = p->next)
{
    printf("%d %d %.2f\n", p->data.id, p->data.course, p->data.score);
}

/* назад */
for (DNode *p = list->tail; p != NULL; p = p->prev)
{
    printf("%d %d %.2f\n", p->data.id, p->data.course, p->data.score);
}
Обратный обход — то, ради чего и заводят prev: не нужно искать последний узел прямым
проходом, достаточно tail.
Разворот двусвязного списка
Развернуть двусвязный список можно двумя способами: переставлять узлы или обменять ссылки. Обмен ссылок проще и не требует ни дополнительных узлов, ни временных списков.
Идея: у каждого узла поменять местами prev и next. Тогда «следующий» станет «предыдущим»,
и обход вперёд пойдёт в обратном направлении. После обмена у всех узлов бывший хвост
становится головой.
void reverse(DList *list)
{
    DNode *p = list->head;

    while (p != NULL)
    {
        DNode *next = p->next;   /* запоминаем следующий до обмена */
        p->next = p->prev;       /* меняем ссылки местами */
        p->prev = next;
        p = next;                /* идём по сохранённому адресу */
    }

    /* Меняем местами head и tail */
    DNode *tmp = list->head;
    list->head = list->tail;
    list->tail = tmp;
}
Пошагово: на каждом витке сохраняют next = p->next, обменивают p->next и p->prev, и
переходят по сохранённому next. Сохранять next до обмена необходимо — после
p->next = p->prev старый следующий уже недоступен. В конце остаётся поменять head и
tail: до разворота голова указывала на первый узел, после обмена ссылок это последний узел
в новом порядке, поэтому голова и хвост меняются местами.
Почему это проще перестановки узлов: не нужно следить за prev/next четырёх соседей при
каждом перемещении, достаточно одного локального обмена внутри узла. Код короче и в нём
меньше мест для ошибки.
Полный пример: вставка, удаление, разворот
Соберём операции в цельную программу с аккуратным освобождением памяти.
#include <stdio.h>
#include <stdlib.h>

typedef struct
{
    int id;
    int course;
    double score;
} Student;

typedef struct DNode
{
    Student data;
    struct DNode *prev;
    struct DNode *next;
} DNode;

typedef struct
{
    DNode *head;
    DNode *tail;
} DList;

/* Прототипы — до main */
void list_init(DList *list);
DNode *make_node(Student s);
void push_front(DList *list, Student s);
void remove_node(DList *list, DNode *p);
void reverse(DList *list);
void print_list(const DList *list);
void free_list(DList *list);

int main(void)
{
    DList list;
    list_init(&list);

    Student a = { 1, 1, 4.80 };
    Student b = { 2, 2, 3.20 };
    Student c = { 3, 3, 4.90 };

    push_front(&list, c);
    push_front(&list, b);
    push_front(&list, a);   /* список: a -> b -> c */

    reverse(&list);         /* список: c -> b -> a */
    print_list(&list);

    free_list(&list);       /* внутри обнуляются head и tail */
    return 0;
}

void list_init(DList *list)
{
    list->head = NULL;
    list->tail = NULL;
}

DNode *make_node(Student s)
{
    DNode *node = malloc(sizeof(*node));
    if (node == NULL)
    {
        return NULL;
    }

    node->data = s;
    node->prev = NULL;
    node->next = NULL;
    return node;
}

void push_front(DList *list, Student s)
{
    DNode *node = make_node(s);
    if (node == NULL)
    {
        return;
    }

    node->next = list->head;
    node->prev = NULL;

    if (list->head != NULL)
    {
        list->head->prev = node;
    }
    else
    {
        list->tail = node;
    }

    list->head = node;
}

void remove_node(DList *list, DNode *p)
{
    if (p == NULL)
    {
        return;
    }

    if (p->prev != NULL)
    {
        p->prev->next = p->next;
    }
    else
    {
        list->head = p->next;
    }

    if (p->next != NULL)
    {
        p->next->prev = p->prev;
    }
    else
    {
        list->tail = p->prev;
    }

    free(p);
}

void reverse(DList *list)
{
    DNode *p = list->head;
    while (p != NULL)
    {
        DNode *next = p->next;
        p->next = p->prev;
        p->prev = next;
        p = next;
    }

    DNode *tmp = list->head;
    list->head = list->tail;
    list->tail = tmp;
}

void print_list(const DList *list)
{
    for (const DNode *p = list->head; p != NULL; p = p->next)
    {
        printf("%d %d %.2f\n", p->data.id, p->data.course, p->data.score);
    }
}

void free_list(DList *list)
{
    DNode *p = list->head;
    while (p != NULL)
    {
        DNode *next = p->next;   /* сохраняем до free */
        free(p);
        p = next;
    }
    list->head = NULL;
    list->tail = NULL;
}
Обратите внимание: free_list освобождает узлы по цепочке next и в конце обнуляет оба
указателя. Обнулять tail обязательно — иначе после освобождения он останется висячим, и
повторное обращение к списку приведёт к ошибке.
Таблица сложности
N — число узлов.
| Операция | Сложность | Комментарий |
|---|---|---|
push_front / push_back | O(1) | есть оба конца через head/tail |
insert_after / вставка перед | O(1) | после нахождения места |
remove_node | O(1) | предыдущий уже известен |
reverse | O(N) | один проход с обменом ссылок |
| поиск по значению | O(N) | обход цепочки |
free_list | O(N) | освобождение каждого узла |
Главный выигрыш по сравнению с односвязным списком — удаление за O(1) без поиска предыдущего и быстрый доступ к хвосту.
Связь с ЛР 3
Двусвязный список — структура повышенной сложности (варианты П1–П5):
| Вариант | Операция |
|---|---|
| П1 | Разворот — обмен prev/next у каждого узла + новый head/tail |
| П2 | Обмен половин — разделение на два блока и сцепление в новом порядке |
| П3 | Циклический сдвиг на K вправо |
| П4 | Разделение на два списка по порогу T (score >= T и score < T) |
| П5 | Чередующееся слияние двух двусвязных списков |
Два предупреждения, специфичных для этой структуры.
При разделении и слиянии легко потерять tail. Когда список разрезают на части или
сцепляют два списка, у каждой части меняется и голова, и хвост. Обновляйте head и tail
у всех участвующих списков, иначе хвост останется указывать в старую часть — и обратный
обход, и последующие операции «уедут» не туда.
Нельзя оставлять висячие prev. При слиянии узлы первого и второго списков должны быть
сцеплены в обе стороны: prev каждого узла обязан смотреть на реального левого соседа.
Если обновить только next, а про prev забыть, нарушится инвариант p->next->prev == p,
и код, который потом пойдёт по prev (разворот, обратный обход), сломается. В П4, где
список делится на два, проверьте, что у новой головы prev == NULL, а у нового хвоста
next == NULL.
Правила ЛР 3 прежние: данные только из input.txt, узлы только через malloc, результат в
output.txt, вся память освобождается в конце.
Частые ошибки
| Ошибка | Что не так |
|---|---|
забыли обновить p->next->prev при вставке | нарушен инвариант, обратный обход сломан |
free(p) до перецепки соседей | обращение к освобождённой памяти |
не обновили head/tail при удалении края | висячие указатели на освобождённый узел |
при развороте не сохранили next до обмена | потерян список |
не обнулили tail в free_list | висячий хвост после освобождения |
при разделении/слиянии не обновили tail | хвост указывает в чужую часть |
оставили висячий prev при слиянии | нарушен p->next->prev == p |
Что запомнить
- У двусвязного узла два указателя —
prevиnext; голова и хвост задают список. - Инварианты:
head->prev == NULL,tail->next == NULL,p->next->prev == p,p->prev->next == p. - При вставке обновляются четыре ссылки; при удалении — две, плюс
head/tailна краях. - Сначала перецепляют соседей, потом
free. - Разворот — обмен
prev/nextу каждого узла и сменаhead/tail; это проще перестановки. - Удаление узла — O(1), поскольку предыдущий уже хранится в
p->prev. - При разделении/слиянии обновляйте
head/tailи не оставляйте висячихprev.