Циклический список
Что такое кольцевой список
Кольцевой (циклический) список — это список, у которого последний узел ссылается не
на NULL, а на первый. Цепочка замыкается в круг:
head -> A -> B -> C -> head (по кругу)
Точнее, если у нас есть указатели head (первый узел) и tail (последний узел), то
инвариант кольца:
tail->next == head
Пустое кольцо — это head == NULL (и тогда tail == NULL). У кольца из одного узла
head == tail, а head->next == head.
Зачем хранить tail. Если держать только head, чтобы добавить элемент в конец, нужно
пройти всё кольцо до последнего узла — это O(N). С tail вставка в конец и в начало
делается за O(1): конец известен сразу, а начало доступно как tail->next. Поэтому
в реализациях ниже кольцо хранит оба указателя.
Типы из ЛР 3: ValueType, Value, CNode
В высоких вариантах (В1–В5) узлы кольца хранят значение, которое может быть либо целым,
либо вещественным. Для этого используют enum + union:
typedef enum
{
    VALUE_INT = 1,     /* тип 1: целое */
    VALUE_DOUBLE = 2   /* тип 2: вещественное */
} ValueType;

typedef struct
{
    ValueType type;        /* какой из членов union актуален */
    union
    {
        int i;             /* значение, если type == VALUE_INT */
        double d;          /* значение, если type == VALUE_DOUBLE */
    } as;
} Value;

typedef struct CNode
{
    Value data;            /* данные узла */
    struct CNode *next;    /* следующий узел кольца */
} CNode;
Как читать и печатать Value
union хранит в одной области памяти либо int, либо double — но не оба сразу. Какой
именно член актуален, подсказывает поле type. Читать «не тот» член — неопределённое
поведение (вы прочитаете биты double как int).
/* Считать один узел из файла: сначала type, потом значение */
CNode *read_value(FILE *in)
{
    int type = 0;
    if (fscanf(in, "%d", &type) != 1)
    {
        return NULL;
    }

    if (type != 1 && type != 2)
    {
        return NULL;           /* в ЛР 3 допустимы только типы 1 и 2 */
    }

    CNode *node = malloc(sizeof(*node));
    if (node == NULL)
    {
        return NULL;
    }

    if (type == 1)
    {
        node->data.type = VALUE_INT;
        if (fscanf(in, "%d", &node->data.as.i) != 1)
        {
            free(node);
            return NULL;
        }
    }
    else /* type == 2 */
    {
        node->data.type = VALUE_DOUBLE;
        if (fscanf(in, "%lf", &node->data.as.d) != 1)
        {
            free(node);
            return NULL;
        }
    }

    node->next = NULL;
    return node;
}

/* Напечатать один узел */
void print_value(const CNode *node)
{
    if (node->data.type == VALUE_INT)
    {
        printf("1 %d\n", node->data.as.i);
    }
    else
    {
        printf("2 %.2f\n", node->data.as.d);
    }
}
Ключевая мысль: сначала прочитали/записали type, потом — соответствующее поле union,
и только его. Никогда не читайте as.d, если type == VALUE_INT, и наоборот.
Обход кольца
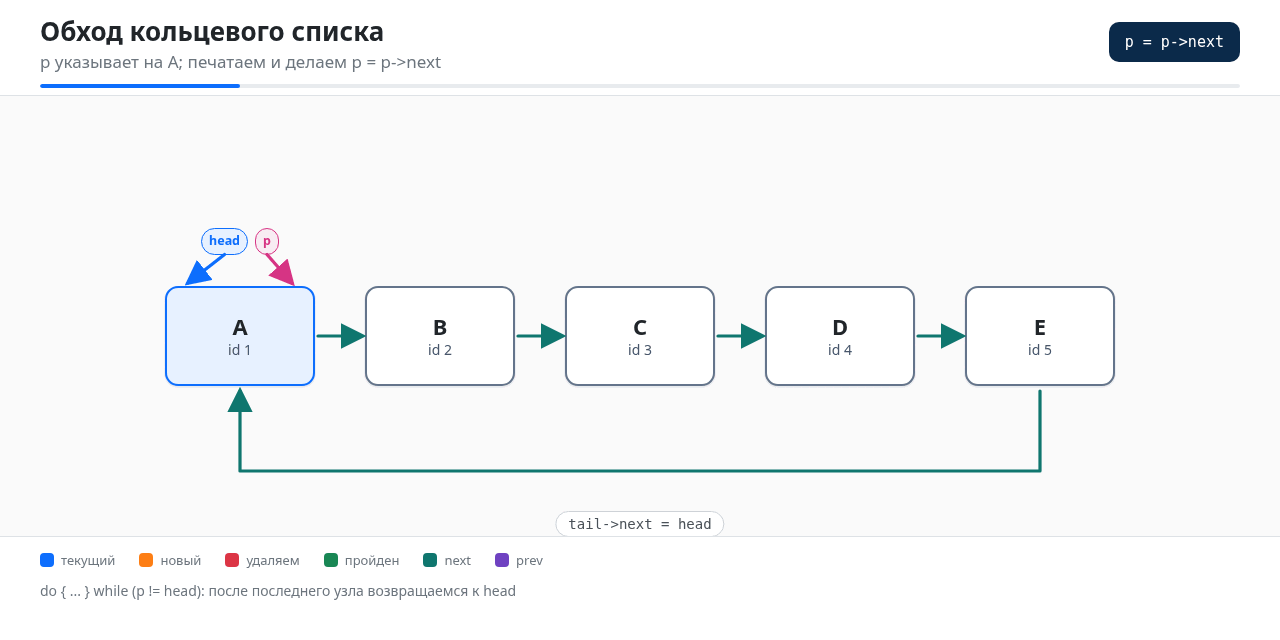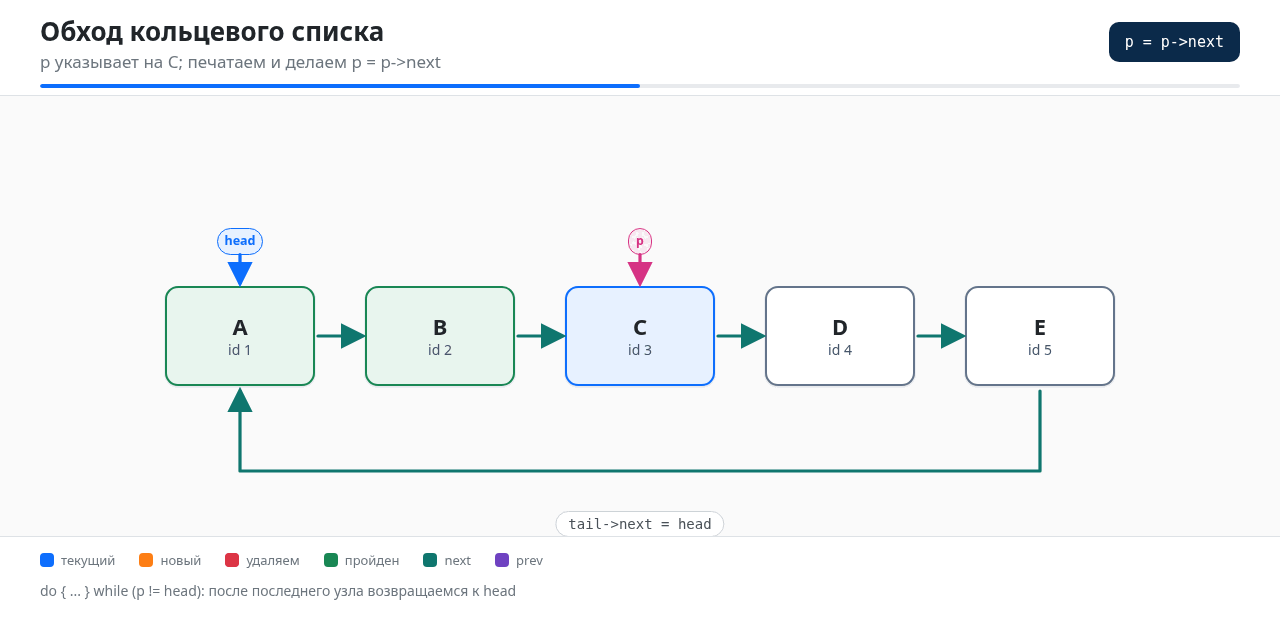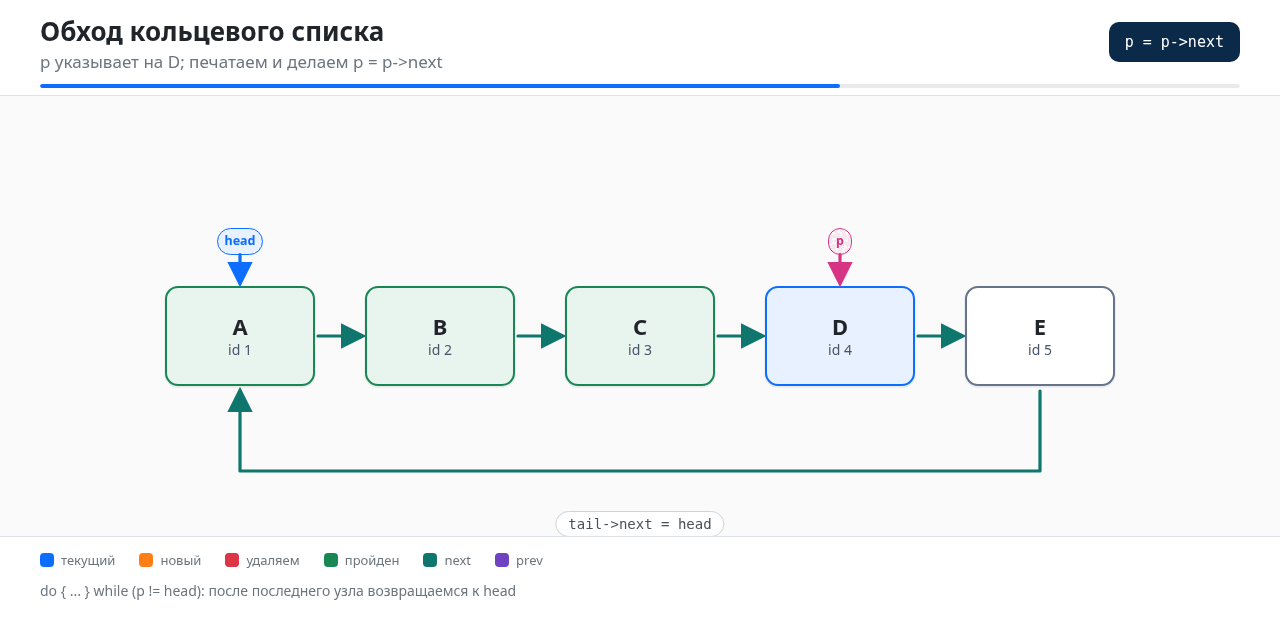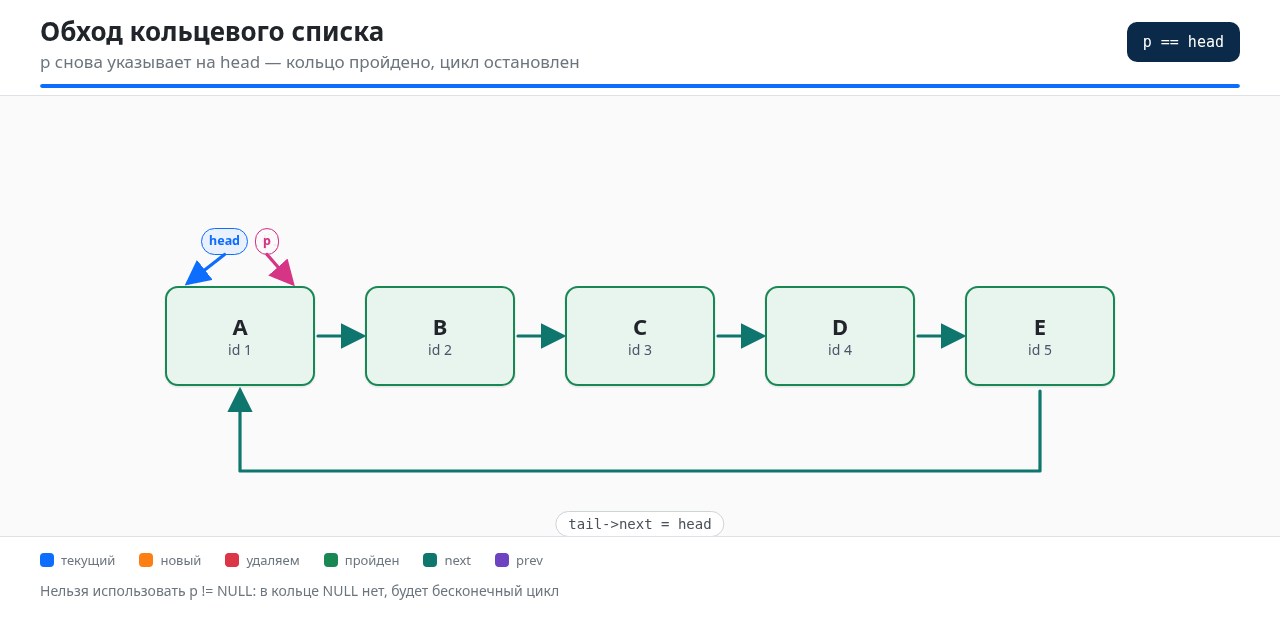
Раз последний узел снова указывает на первый, обычное условие p != NULL в кольце никогда
не сработает: в кольце нет NULL, цикл станет бесконечным. Поэтому обход строят через
do ... while с остановкой по возвращению к голове:
void print_ring(const CNode *head)
{
    if (head == NULL)
    {
        return;                 /* пустое кольцо — печатать нечего */
    }

    const CNode *p = head;
    do
    {
        print_value(p);
        p = p->next;
    } while (p != head);        /* вернулись к началу — обошли всё */
}
Почему do ... while, а не while? Нам нужно обработать первый узел до проверки: если
начать с while (p != head), тело не выполнится ни разу, ведь изначально p == head.
Если внутри цикла нужно обработать каждый узел ровно один раз, следите, чтобы сдвиг
p = p->next стоял после обработки и до проверки — иначе последний узел либо пропустите,
либо обработаете дважды.
Длина кольца
int ring_length(const CNode *head)
{
    if (head == NULL)
    {
        return 0;
    }

    int count = 0;
    const CNode *p = head;
    do
    {
        count++;
        p = p->next;
    } while (p != head);
    return count;
}
Вставка в кольцо
Вставка в начало
Новый узел становится новым head, а старый хвост должен ссылаться на него:
CNode *insert_front(CNode *head, CNode **tail, int type, int ival, double dval)
{
    CNode *node = malloc(sizeof(*node));
    if (node == NULL)
    {
        return head;
    }

    /* заполняем data по type */
    node->data.type = (type == 1) ? VALUE_INT : VALUE_DOUBLE;
    if (type == 1)
    {
        node->data.as.i = ival;
    }
    else
    {
        node->data.as.d = dval;
    }

    if (head == NULL)
    {
        /* пустое кольцо: узел сам на себя */
        node->next = node;
        *tail = node;
        return node;
    }

    /* непустое кольцо */
    node->next = head;       /* новый узел ссылается на старую голову */
    (*tail)->next = node;    /* старый хвост замыкается на новый узел */
    return node;             /* новая голова */
}
Здесь три шага в непустом случае, и их порядок важен:
node->next = head— связали новый узел со старым кольцом.(*tail)->next = node— замкнули кольцо на новый узел.return node— вернули новую голову.
Если сделать шаг 2 до шага 1, вы перезапишете tail->next, и старая голова станет
недостижимой — кольцо «порвётся». tail при вставке в начало не меняется: хвост
остался тем же узлом, просто теперь он ссылается на нового соседа.
Вставка в конец
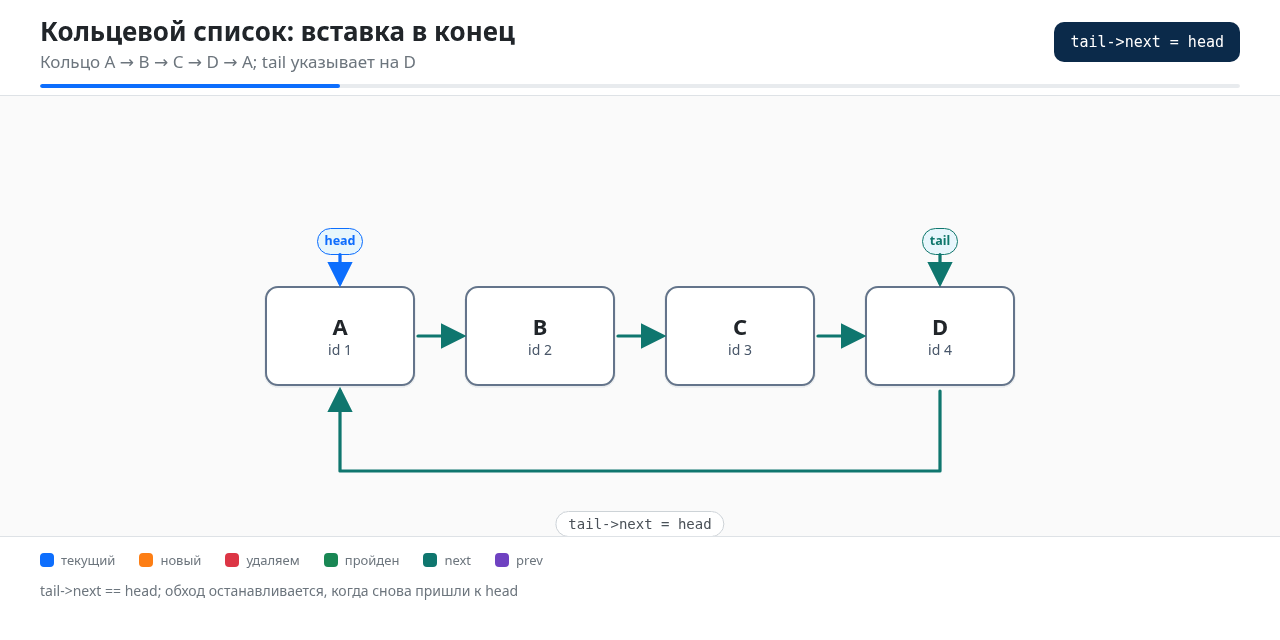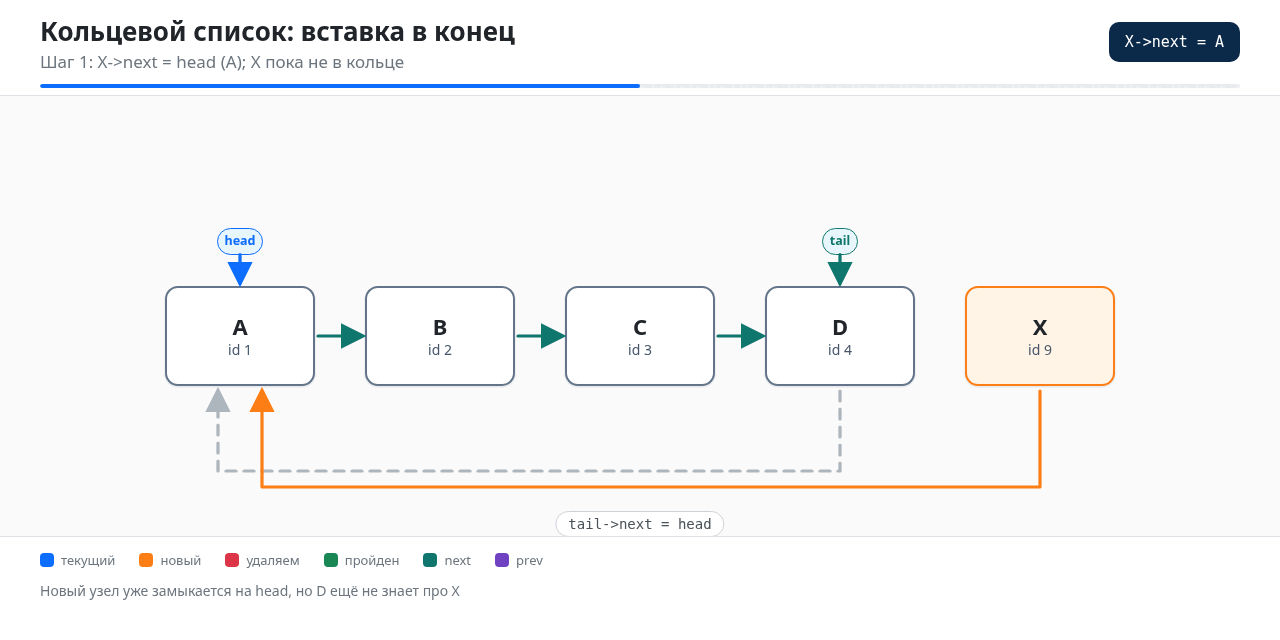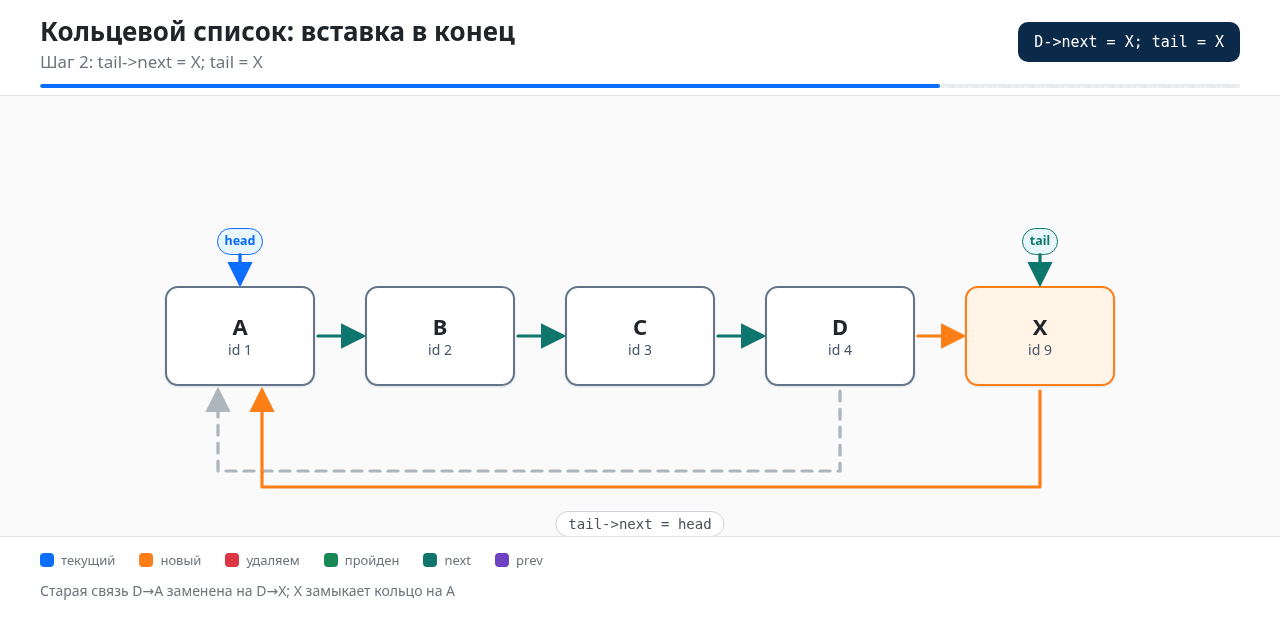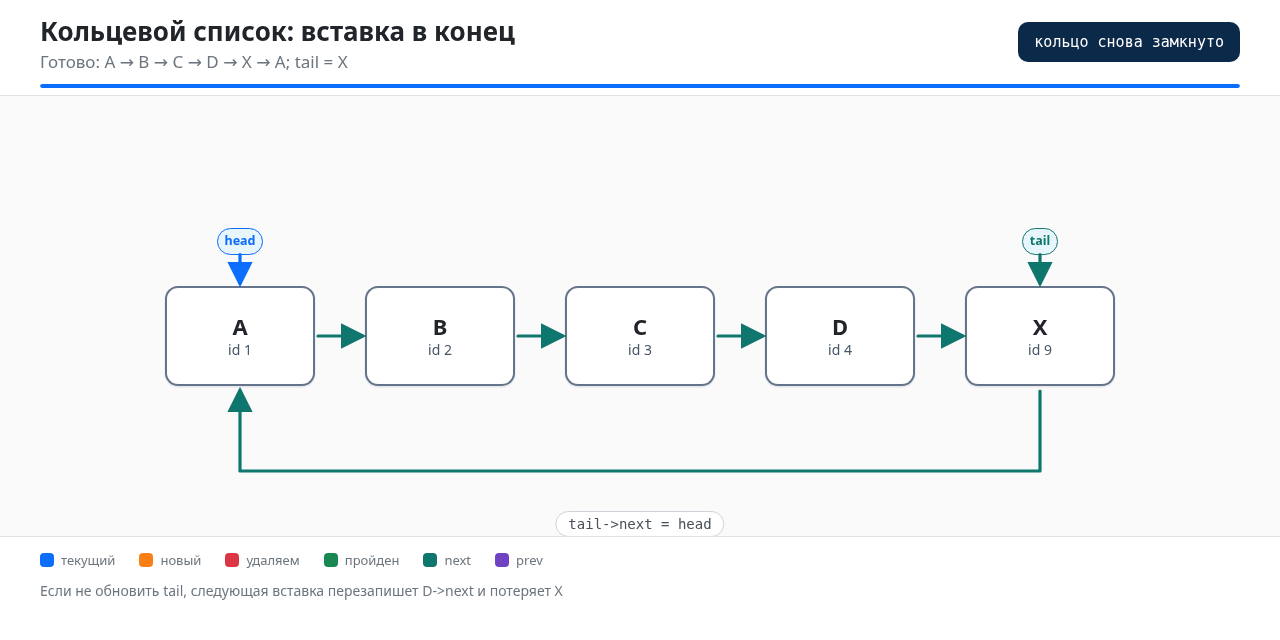
Симметрично, но здесь меняется tail:
CNode *insert_back(CNode *head, CNode **tail, int type, int ival, double dval)
{
    CNode *node = malloc(sizeof(*node));
    if (node == NULL)
    {
        return head;
    }

    node->data.type = (type == 1) ? VALUE_INT : VALUE_DOUBLE;
    if (type == 1)
    {
        node->data.as.i = ival;
    }
    else
    {
        node->data.as.d = dval;
    }

    if (head == NULL)
    {
        node->next = node;
        *tail = node;
        return node;
    }

    node->next = head;       /* новый узел замыкается на голову */
    (*tail)->next = node;    /* старый хвост ссылается на новый узел */
    *tail = node;            /* новый узел становится хвостом */
    return head;
}
Если забыть *tail = node, то tail продолжит указывать на старый хвост: новый узел
фактически в кольце есть, но вставка в конец через tail пойдёт «не туда», а длина,
посчитанная от head, и длина, видимая через tail, разойдутся.
Удаление узла из кольца
Чтобы удалить узел, нужно знать узел перед ним. Удобно передавать указатель на
предыдущий узел prev, а удалять prev->next:
/* Удалить узел, следующий за prev; вернуть нового "prev" или NULL */
CNode *remove_after(CNode **head, CNode **tail, CNode *prev)
{
    if (*head == NULL)
    {
        return NULL;              /* пустое кольцо */
    }

    CNode *target = prev->next;   /* узел, который удаляем */

    /* Если остаётся один узел — он указывал сам на себя */
    if (target == *head && target->next == *head)
    {
        free(target);
        *head = NULL;
        *tail = NULL;
        return NULL;
    }

    prev->next = target->next;    /* «перепрыгиваем» удаляемый узел */

    if (target == *head)
    {
        *head = target->next;     /* удаляем голову — двигаем её */
    }
    if (target == *tail)
    {
        *tail = prev;             /* удаляем хвост — двигаем его */
    }

    free(target);
    return prev;
}
Разберём три особых случая.
- Кольцо из одного узла.
target == *headиtarget->next == *head: удаляя единственный узел, кольцо исчезает — оба указателя обнуляем. Без отдельной веткиprev->next = target->nextоставила быprev->nextравным самому себе уже послеfree, что дало бы висячий указатель. - Удаляем голову.
headнадо переставить на следующий узел, иначе он указывает в освобождённую память. - Удаляем хвост.
tailнадо переставить наprev, иначе хвост висит.
Порядок операций критичен: сначала перецепляем prev->next, потом чиним head/tail,
и только в конце free(target). Если освободить узел до перецепки, читать target->next
будет уже нельзя.
Разворот кольца
Развернуть кольцо — значит изменить направление обхода: каждый узел ссылается не на следующего, а на предыдущего. Сделаем это за один проход, как для обычного списка, но с замыканием в конце:
CNode *reverse_ring(CNode *head)
{
    if (head == NULL)
    {
        return NULL;
    }

    CNode *prev = NULL;
    CNode *cur = head;
    CNode *first = head;     /* запомнили, куда замыкать */

    do
    {
        CNode *next = cur->next;  /* сохраняем следующего */
        cur->next = prev;         /* разворачиваем ссылку */
        prev = cur;
        cur = next;
    } while (cur != first);

    /* теперь "prev" — новый хвост, он должен замкнуться на новую голову */
    first->next = prev;
    return prev;             /* новая голова — бывший последний узел */
}
Внимание: после разворота голова меняется, а tail, если вы его храните, тоже надо
обновить — теперь хвостом стал старый head (first). Не забудьте вернуть оба указателя
согласованными, иначе инвариант tail->next == head нарушится.
Разделение кольца на два
Разделить кольцо на две половины можно, «разрезав» его в двух местах и замкнув каждую
часть. Пусть head — голова первого кольца, mid — первый узел второй половины. Тогда:
/* Разделить кольцо на два: [head..mid_prev] и [mid..tail].
   Возвращает голову второй части, первая остаётся в *head. */
CNode *split_ring(CNode **head, CNode **tail, CNode *mid)
{
    if (*head == NULL)
    {
        return NULL;              /* нечего делить */
    }

    if (mid == *head)
    {
        return NULL;              /* вторая часть пуста */
    }

    /* Найти узел перед mid — он станет хвостом первой части */
    CNode *first_tail = *head;
    while (first_tail->next != mid)
    {
        first_tail = first_tail->next;
    }

    CNode *second_head = mid;     /* голова второй части */
    CNode *second_tail = *tail;   /* хвост второй части — старый хвост */

    /* Разрезаем: хвост первой части замыкаем на её голову,
       хвост второй части уже ссылается на старый head — замыкаем на mid */
    first_tail->next = *head;
    second_tail->next = second_head;

    *tail = first_tail;           /* хвост первой части */

    return second_head;
}
Главное здесь — не потерять tail. После разрезания хвост первой части — это узел
перед mid, а хвост второй части — старый tail. Если перепутать, одна из частей окажется
незамкнутой или «съест» узлы другой.
Отдельно проверьте вырожденные случаи: пустое кольцо (делить нечего) и mid == head
(вторая часть пуста — возвращать нечего).
Слияние двух колец
Слить два кольца — соединить хвост первого с головой второго и хвост второго с головой первого:
/* Слить кольца (h1,t1) и (h2,t2) в одно; вернуть голову результата.
   Второе кольцо может быть пустым. */
CNode *merge_rings(CNode *h1, CNode *t1, CNode *h2, CNode *t2,
                   CNode **out_tail)
{
    if (h1 == NULL)
    {
        *out_tail = t2;        /* первое пусто — результат = второе */
        return h2;
    }
    if (h2 == NULL)
    {
        *out_tail = t1;        /* второе пусто — результат = первое */
        return h1;
    }

    /* Соединяем хвост первого с головой второго */
    t1->next = h2;
    /* Хвост второго замыкаем на голову первого */
    t2->next = h1;

    *out_tail = t2;            /* новый хвост — хвост второго кольца */
    return h1;
}
Важное замечание для ЛР 3: второе кольцо в варианте В4 может быть пустым. В примере
ввода вторая часть задана всего двумя элементами, но по условию допустимо и ноль. Код выше
корректно обрабатывает оба пустых случая и возвращает согласованную пару «голова–хвост».
Если не проверить h2 == NULL и разыменовать t2, программа упадёт на пустом втором
кольце.
Задача Иосифа
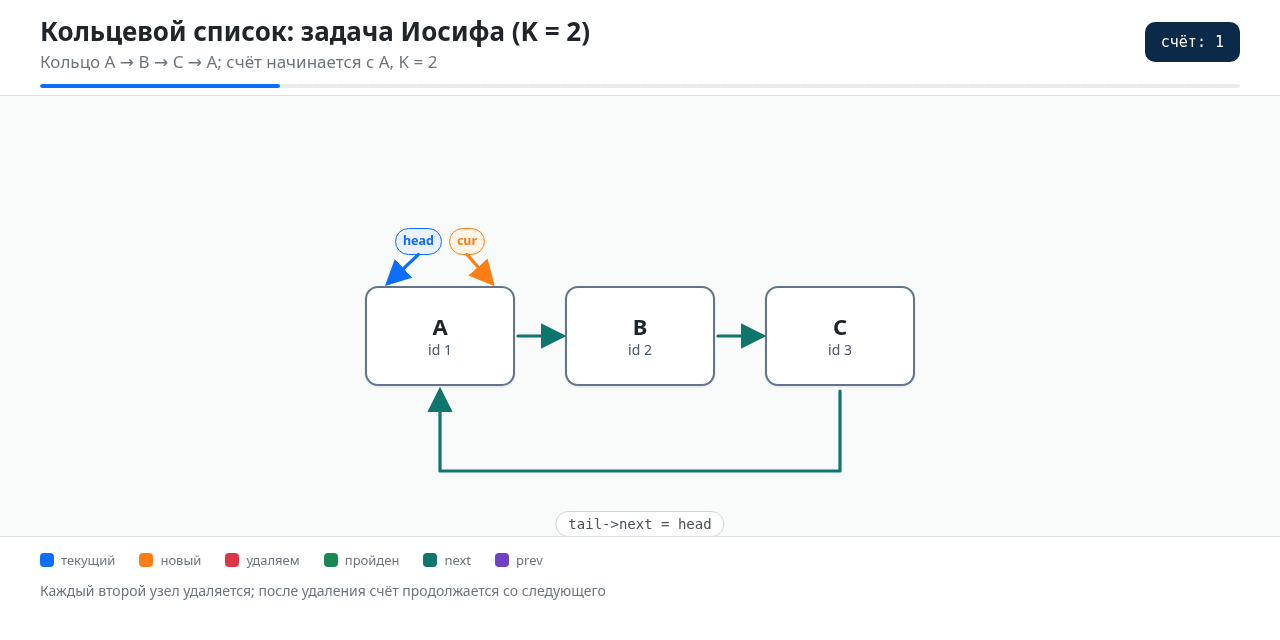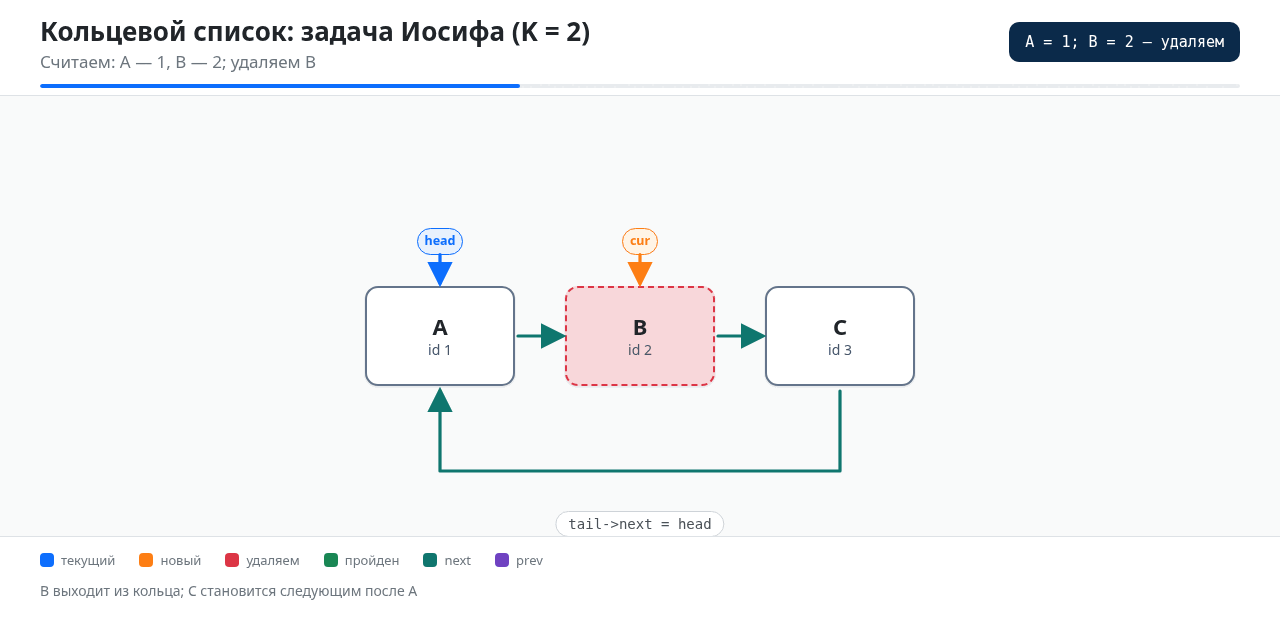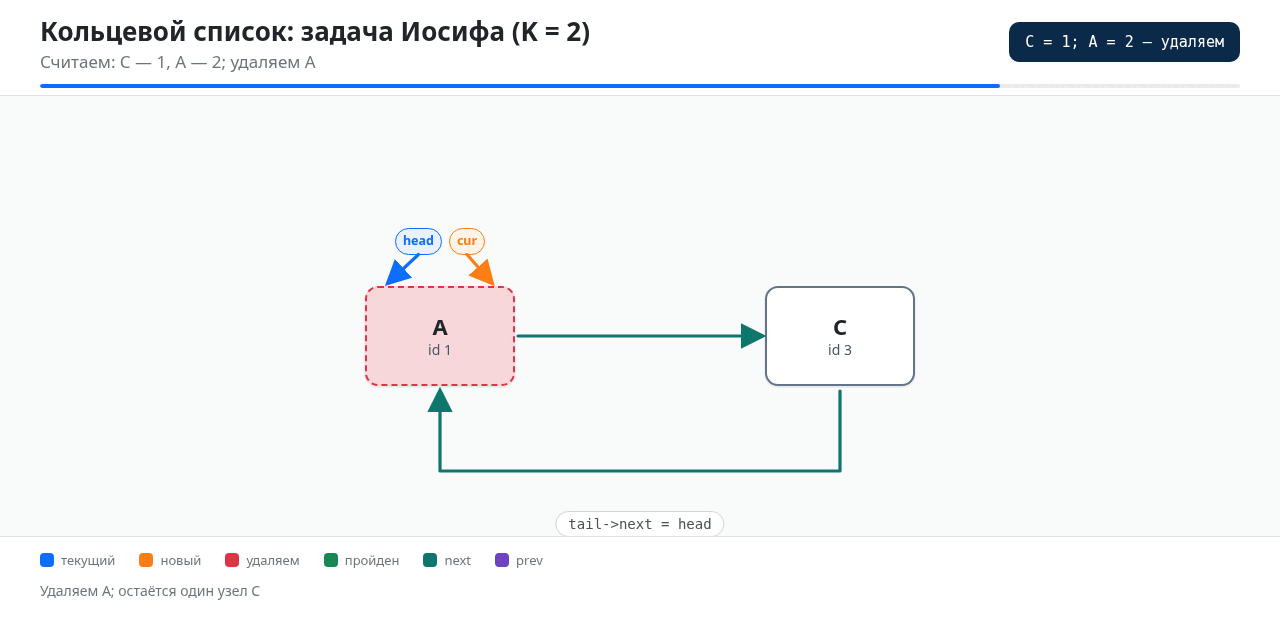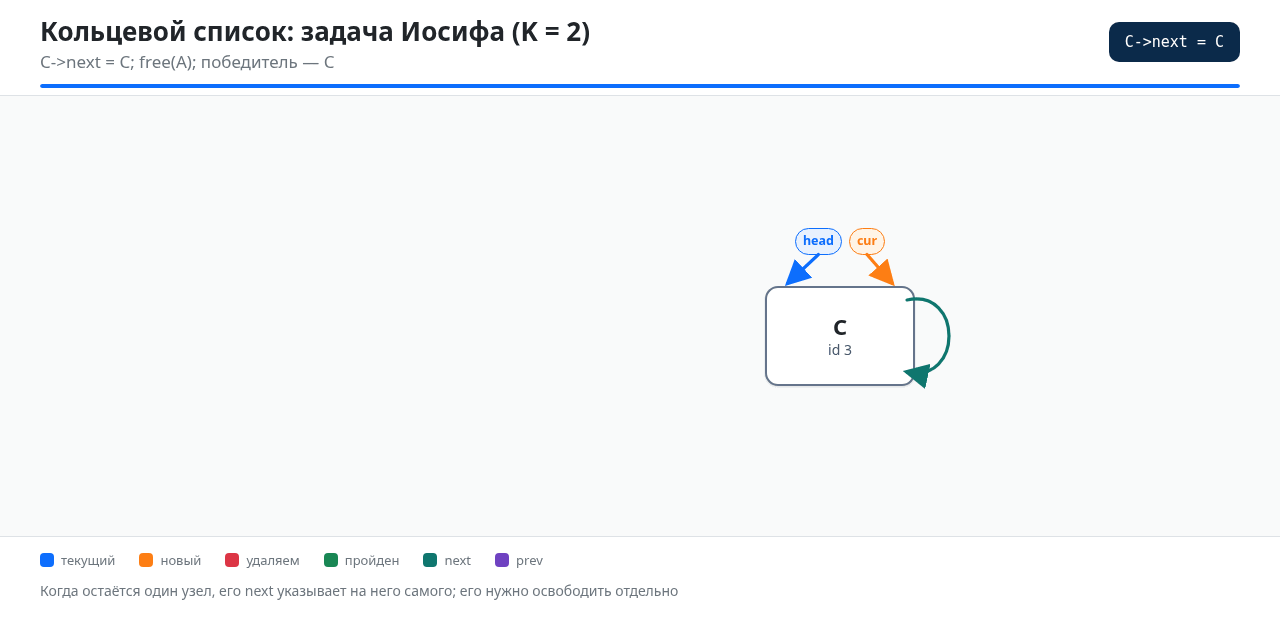
Классическое применение кольцевого списка — задача Иосифа: N человек стоят по кругу,
счёт ведётся по кругу, каждый K-й выбывает, счёт продолжается со следующего. Нужно найти
последнего оставшегося. Кольцо здесь — естественная модель: удаление происходит по кругу,
и список сам «возвращается» к началу.
/* Задача Иосифа: каждый K-й узел удаляется. Возвращает последний оставшийся. */
CNode *josephus(CNode *head, int k)
{
    if (head == NULL || k <= 0)
    {
        return head;
    }

    if (head->next == head)
    {
        return head;             /* уже один узел */
    }

    CNode *prev = head;
    while (prev->next != head)
    {
        prev = prev->next;       /* prev — узел перед головой */
    }

    CNode *cur = head;
    while (cur->next != cur)     /* пока в кольце больше одного узла */
    {
        for (int i = 1; i < k; i++)
        {
            prev = cur;          /* двигаемся на K шагов */
            cur = cur->next;
        }

        prev->next = cur->next;  /* удаляем cur */
        CNode *next = cur->next;
        free(cur);
        cur = next;
    }

    return cur;                  /* последний оставшийся */
}
Обратите внимание: узел prev всегда хранит узел перед cur, поэтому удаление сводится
к одному присваиванию prev->next = cur->next. Последний оставшийся узел функция возвращает,
но не освобождает — его нужно free отдельно после того, как он больше не нужен.
Связь с ЛР 3
Кольцевой список — это структура высоких вариантов В1–В5. Все они читают input.txt,
строят кольцо из Value (enum + union) и пишут результат в output.txt.
- В1 — сдвиг кольца на K вправо. На кольце сдвиг — это просто перенос «начала»:
новый
headстановитсяK-м по счёту узлом, аtailпри этом не теряется. - В2 — обмен половин. Разделите кольцо на две части (см. раздел «Разделение») и слейте их в обратном порядке (см. «Слияние»).
- В3 — разделение по типу. Пройдите кольцо и разложите узлы в два кольца — целые
(
type == 1) и вещественные (type == 2), сохраняя порядок внутри каждого. - В4 — слияние двух колец. Ровно функция
merge_rings; помните, что второе кольцо может быть пустым. - В5 — разворот кольца. Ровно
reverse_ring; не забудьте обновить иhead, иtail.
Общие предупреждения для В1–В5:
- Первое кольцо всегда непустое (
N >= 1), а второе в В4 может быть пустым — проверяйтеh2 == NULL. - При разделении и слиянии не теряйте
tail. После любой перестройки инвариантtail->next == headдолжен выполняться для каждого кольца. - Соблюдайте дисциплину union: печатаете
intтолько приtype == 1,doubleтолько приtype == 2; вещественные значения выводите с%.2f.
Частые ошибки
| Ошибка | Что не так |
|---|---|
обход while (p != NULL) по кольцу | в кольце нет NULL — бесконечный цикл |
обход while (p != head) вместо do ... while | первый узел не обрабатывается |
читаете as.d при type == VALUE_INT | неопределённое поведение (union) |
забыли *tail = node при вставке в конец | хвост указывает не туда |
забыли переставить head/tail при удалении | указатели висят в освобождённой памяти |
| не обработали кольцо из одного узла при удалении | prev->next ссылается сам на себя после free |
разделили/слили, потеряв tail | кольцо не замкнуто, инвариант нарушен |
| не проверили пустое второе кольцо (В4) | разыменование NULL |
| не освободили последний узел задачи Иосифа | утечка |
Что запомнить
- В кольце последний узел ссылается на первый:
tail->next == head. - Пустое кольцо —
head == NULL; кольцо из одного узла —head->next == head. tailнужен, чтобы вставка в конец была O(1).- Обход кольца — только
do { ... } while (p != head). unionхранит либоint, либоdouble; актуальный член определяетtype.- Порядок перецепки при вставке/удалении критичен;
free— только после перецепки. - При разделении и слиянии сохраняйте
tailи инвариантtail->next == head. - Во втором кольце (В4) проверяйте пустоту.
Самопроверка: обход кольца из одного узла
Сколько раз выполнится тело цикла do { ... } while (p != head) на кольце из одного узла,
и почему while (p != head) для него не годится?
Тело выполнится ровно один раз: узел обрабатывается, затем p = p->next снова становится
равным head, и условие p != head ложно. Цикл while (p != head) не выполнится ни разу,
потому что изначально p == head, — единственный узел был бы пропущен.